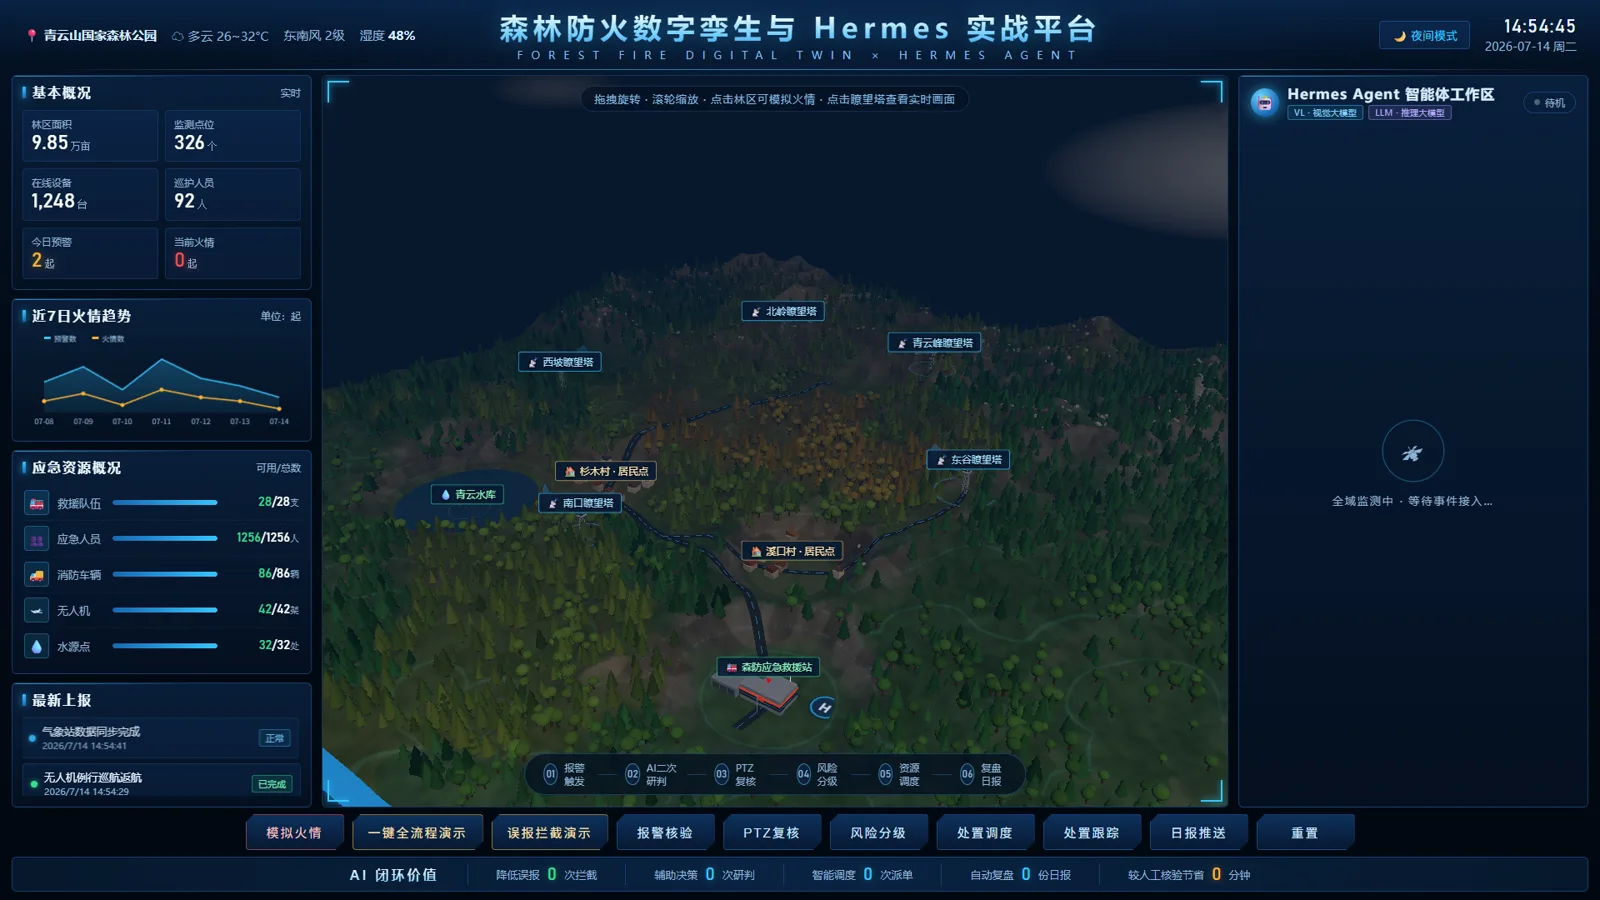
Hermes 森林防火报警研判:用 2B 小模型给报警分流
云雾、炊烟、反光让摄像头误报很多,值班员要逐条复核。基于 Qwen3.5-2B 做轻量判断模型,只输出真警 / 误报和置信度:高置信度自动派单,低置信度转人工。
- 2B轻量判断模型
- 5 张/秒300I A2 单卡测试吞吐
- AI-Box端侧验证中
森林防火
交互演示 ↗
AI 应用产品经理 · 成都
让机器干确定的活,把拿不准的交给人。
近 10 年产品经验,近 5 年在森林防火、草原、水利、食安养老这些公共领域做 AI 产品。习惯先做一个能跑的原型,再坐下来谈方案。
工作之外:旅行 18 地 · 咖啡 · 两狗一猫
我主导或负责的 AI 项目。每篇写清四件事:当时的约束、我做的判断、最后的结果、做错了什么。
项目界面配图为 AI 生成的示意图,客户名称、地名和业务数据已隐去。标有「交互演示」的是我个人做的演示版,数据为虚构。
云雾、炊烟、反光让摄像头误报很多,值班员要逐条复核。基于 Qwen3.5-2B 做轻量判断模型,只输出真警 / 误报和置信度:高置信度自动派单,低置信度转人工。
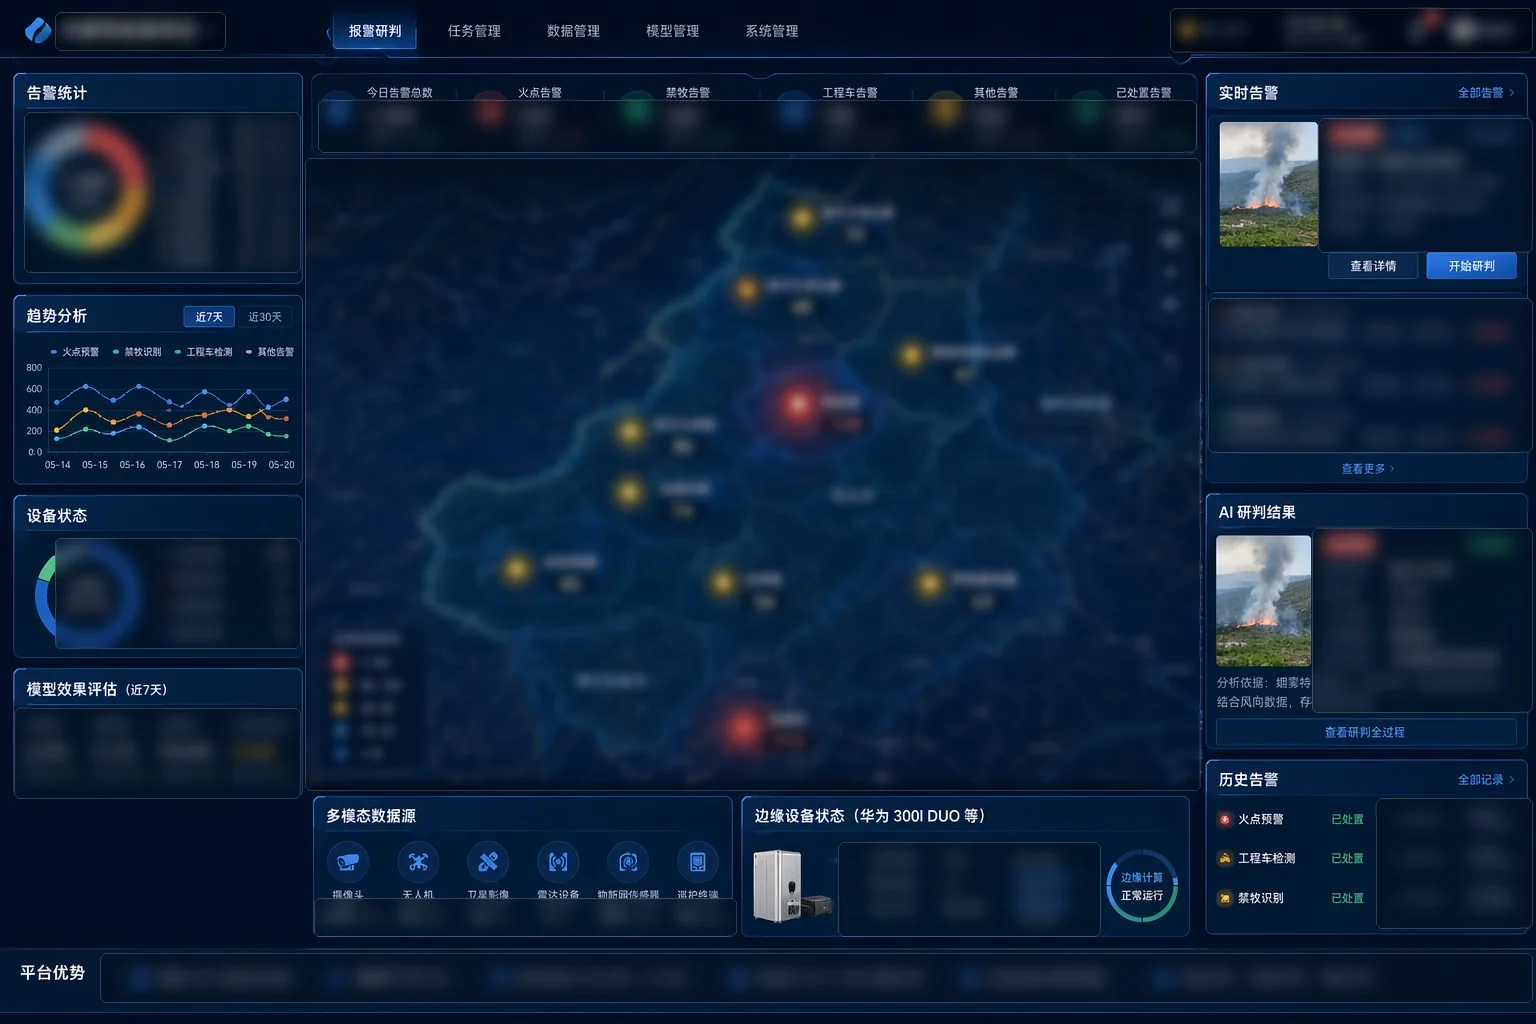
草原监管原来靠人工盯屏,特殊场景多、误报高、研判慢。我负责产品方案:拆解火点预警、禁牧识别、工程车检测等 10 余类任务,采用 VLM + RAG,设计困难样本回流,完成昇腾边缘设备适配。
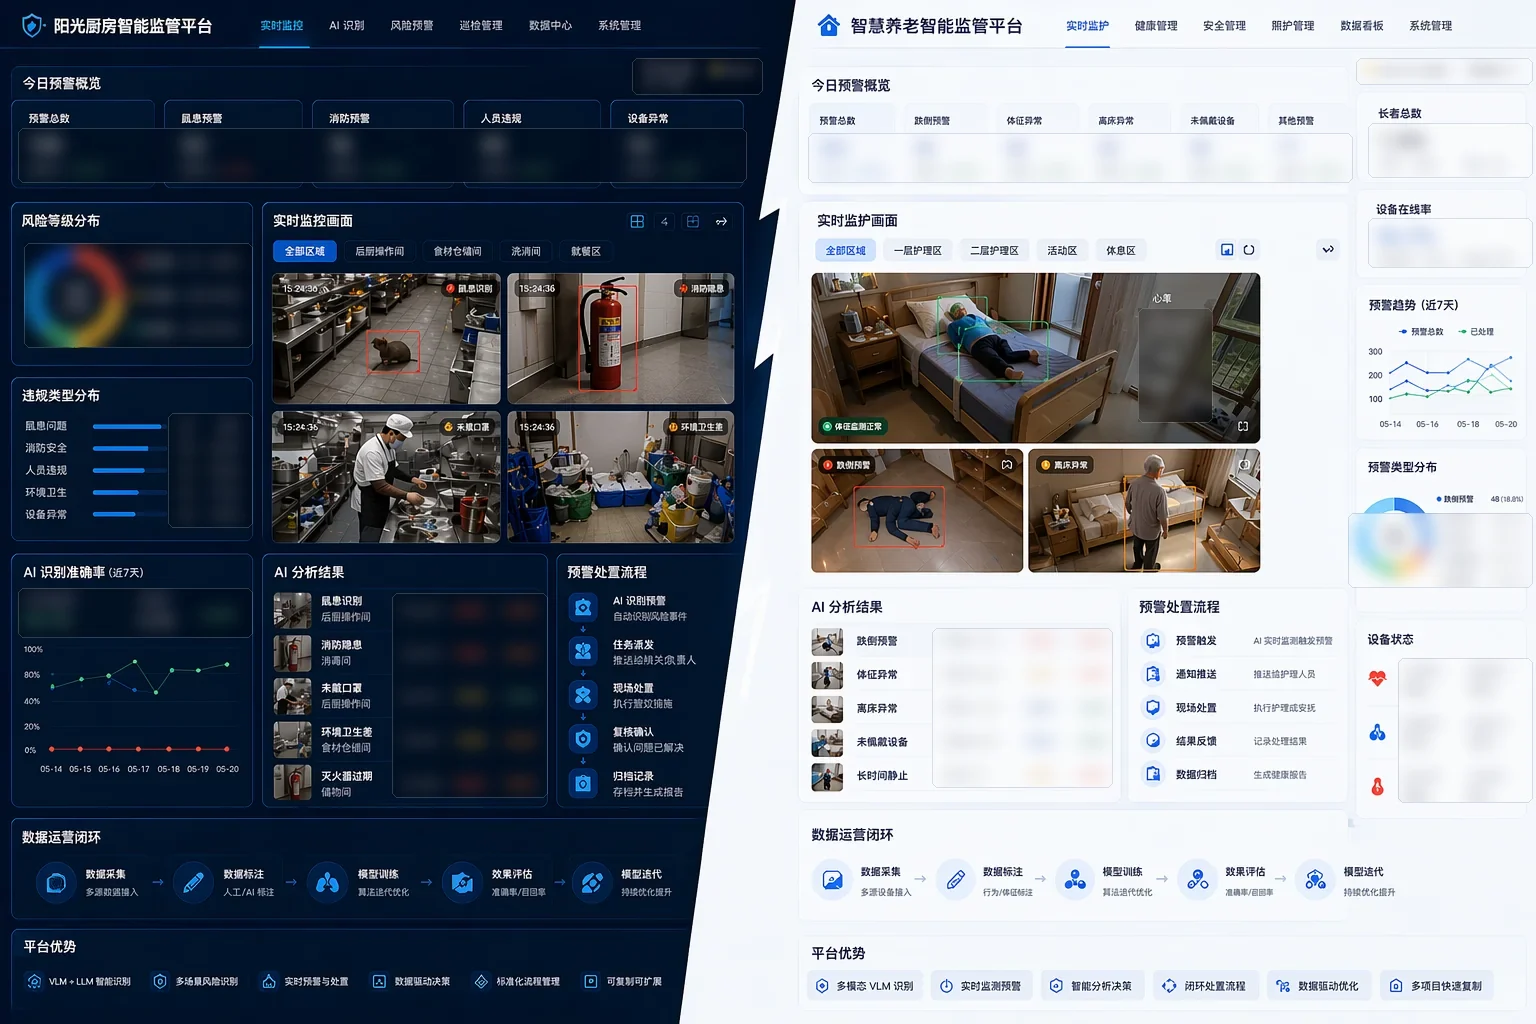
后厨和社区养老的监管原来靠人工巡检和纸质报告,只能抽查,问题发现得晚。用视觉识别、大模型研判加 Agent 派单,覆盖 20 余类识别任务,自动生成异常报告并派发任务。
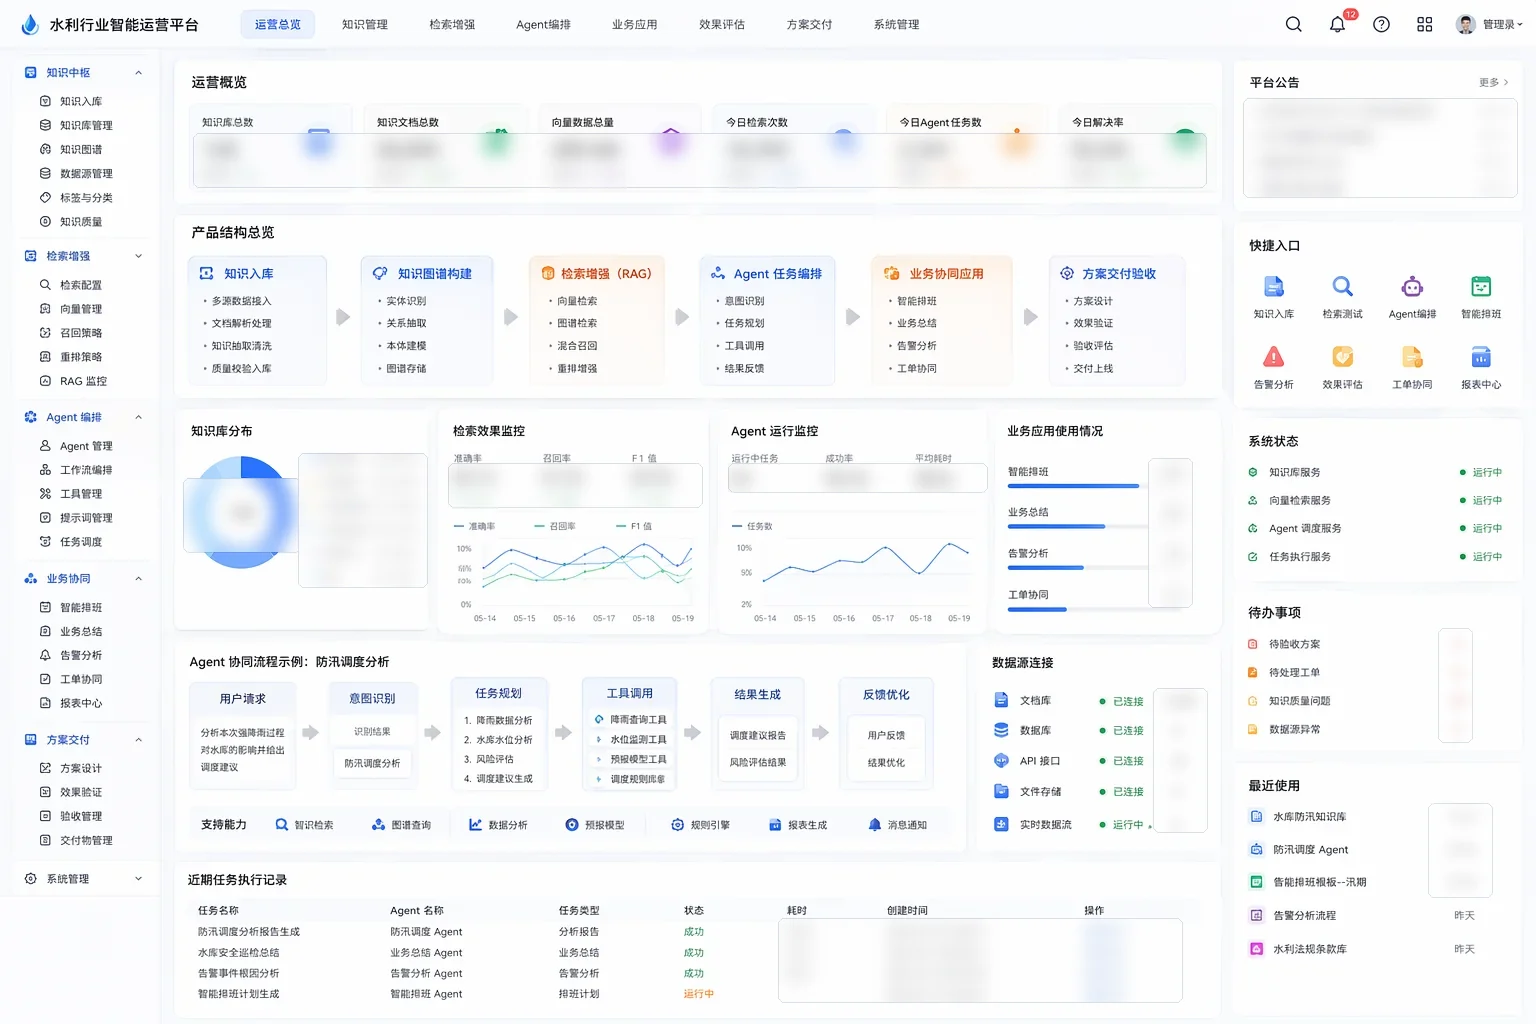
行业知识库最怕做成摆设:资料堆进去了,问答时好时坏,演示很漂亮,业务人员却不愿意用。我从资料整理、问答一致性和任务型 Agent 三处下手,从方案设计一路跟到交付。
两个做过完整方案推演的场景,思路和上面的项目一脉相承。
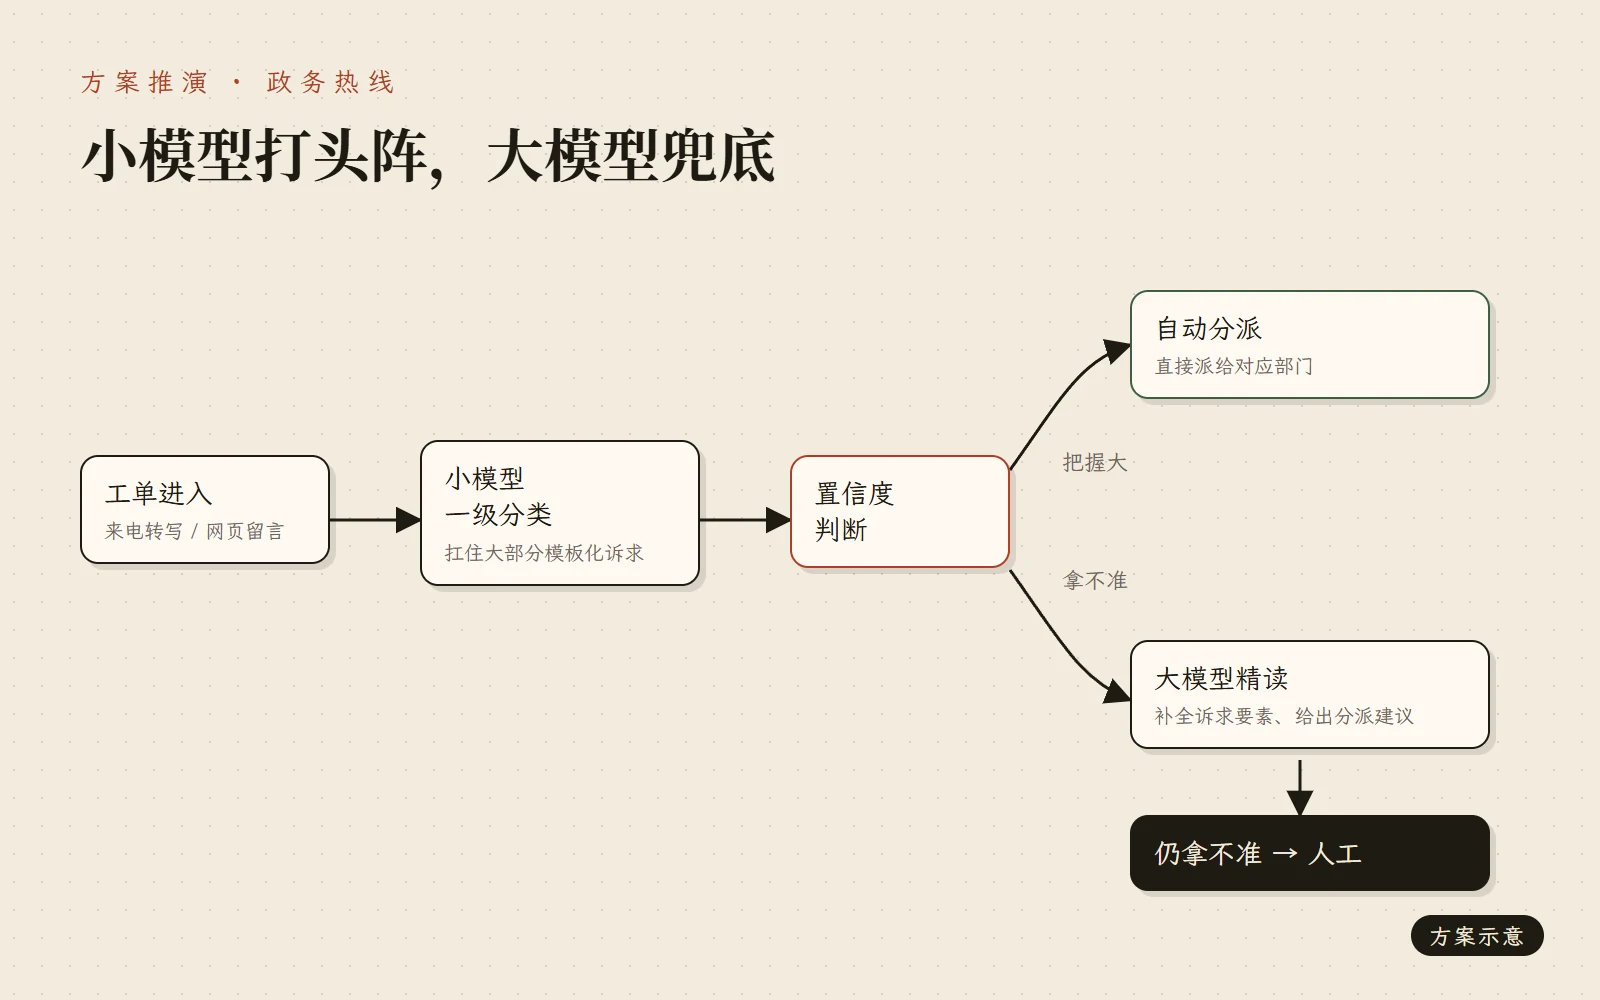
热线工单里有大量模板化诉求。让小模型做一级分类扛住量,疑难工单交给大模型精读,仍拿不准的转人工。最难的一环,是教会系统说"我不确定"。
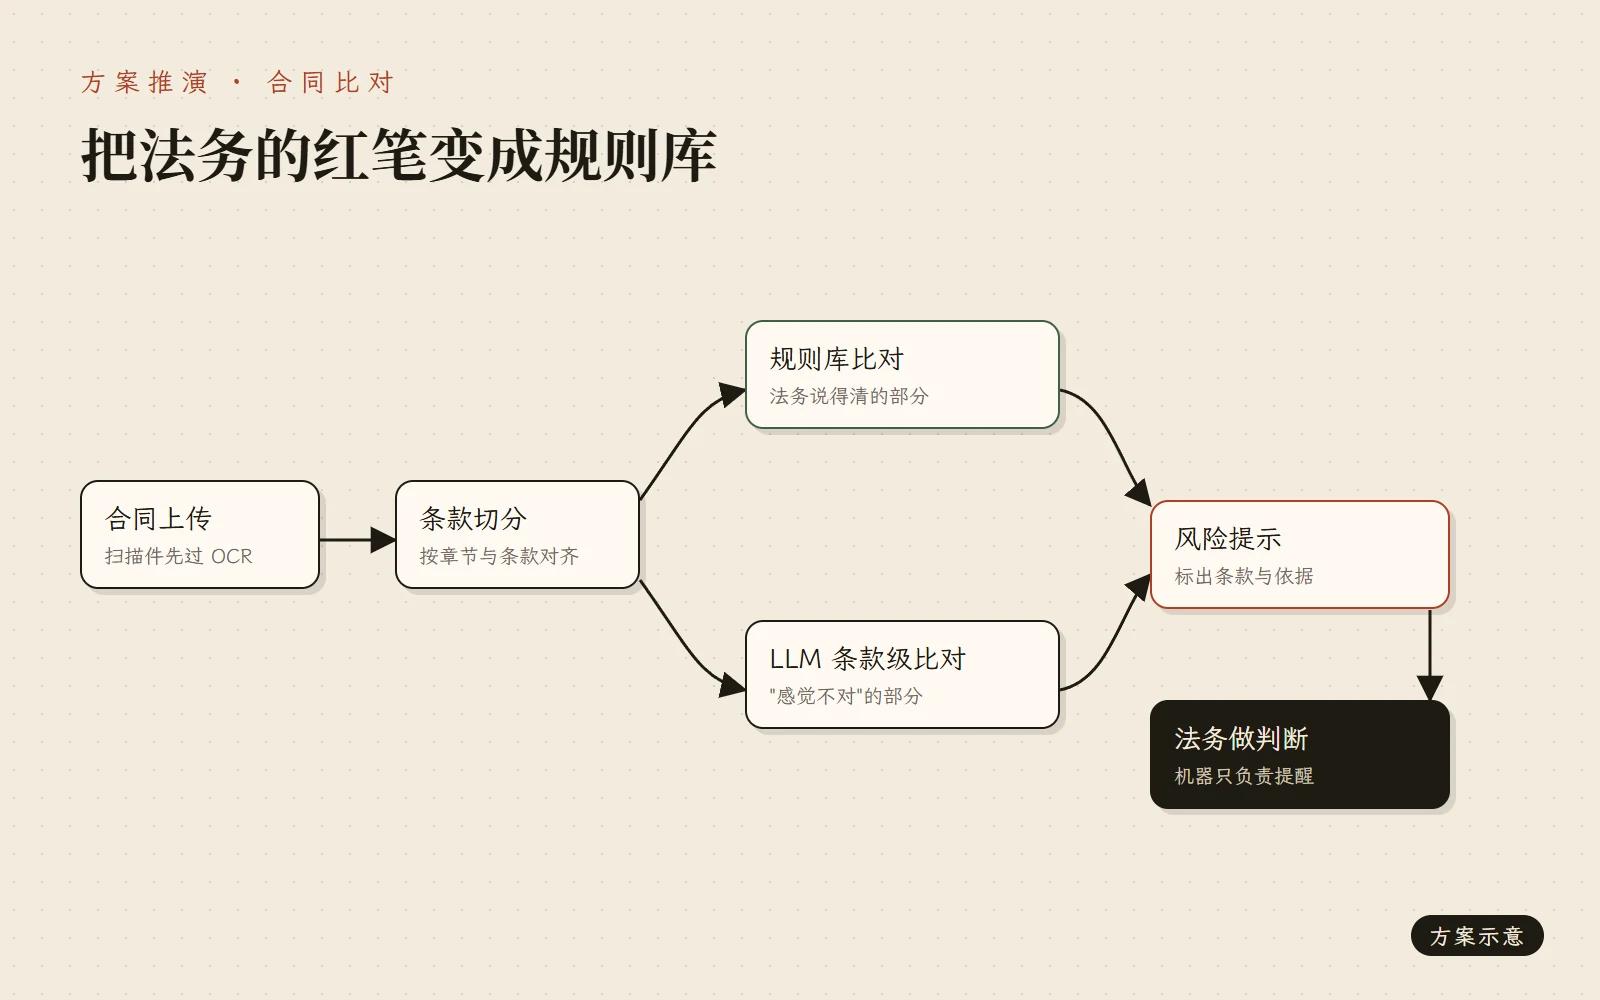
从关键词规则升级到 LLM 条款级比对。推演下来,最大的收获在模型之外:把法务口中的"感觉不对"翻译成可执行的检查清单。风险提示可以自动化,判断依然属于人。
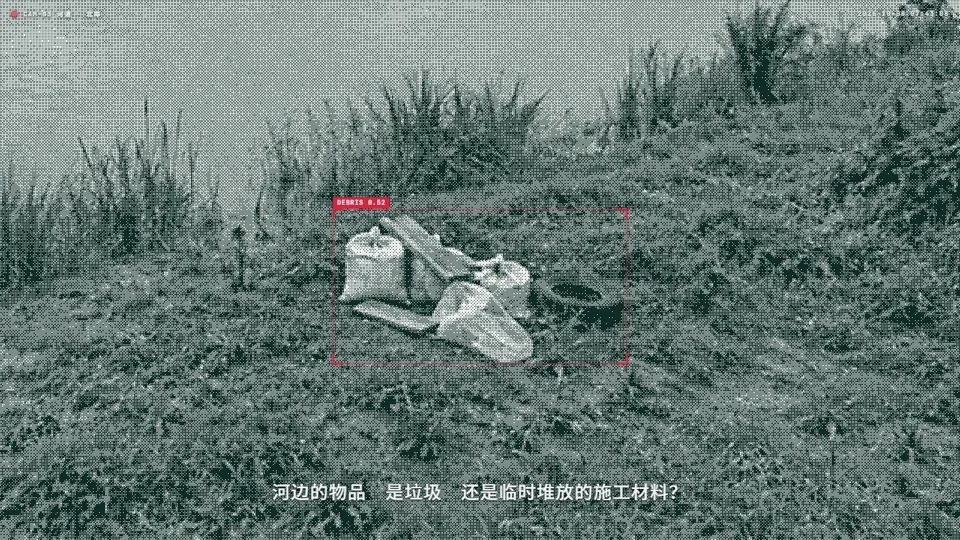
森林防火靠摄像头值守,报警量大。云雾、炊烟、水面反光都可能被识别成烟火,误报一多,值班员只能逐条点开复核,真正的火情反而容易被淹没在一堆"疑似"里。视觉大模型看得更准,但推理成本高,部署不到前端设备上。
产品负责人。负责 Hermes 报警研判与处置方案:模型该输出什么、数据怎么准备、报警怎么分流、处置结果怎么回到训练里。
力气花得最多的是数据。先定历史报警图像的清洗规则:去重,剔除模糊、过曝的图片;再统一可见光和热成像、白天和夜间的标注口径;误报样本整理成困难负样本,持续补进训练,用 LoRA / SFT 做场景适配。
300I A2 单卡测试吞吐 5 张/秒,正在做 AI-Box 端侧验证,目前在客户试点。试点有了结论,这篇会接着更新。
标注口径。可见光和热成像、白天和夜间,看起来都是"烟火",判断依据却不一样。口径不统一,模型学到的就是标注员之间的分歧。所以补数据之前,先把口径写成文档,再开始标。
上方的交互演示用虚构数据还原了报警接入、模型研判、云台复核、风险分级、资源调度到复盘日报的完整过程,可以直接运行。
草原监管原来靠人工盯屏研判。防火要盯烟火,禁牧要盯牲畜有没有进禁牧区,还要留意工程车这类对象。草原上的场景变化大,特殊情况多,结果是误报高、研判慢,值班人员疲于奔命。
产品方案负责人,覆盖防火与禁牧两条业务线,项目合同为百万级。
部署端推进了量化、推理优化和昇腾边缘设备适配,让研判尽量在离现场近的地方完成。
典型场景识别准确率 89%。"典型场景"这个限定词很重要:草原上总有模型没见过的情况,我更愿意把能稳定做到的范围说清楚,剩下的交给回流机制慢慢补。
只报一个总准确率,好做的任务会把难做的任务藏起来。按任务分开评测,哪类任务在拖后腿一眼就能看出来,资源也知道该往哪里投。
后厨和社区养老的监管,原来靠人工巡检和纸质报告。巡检只能抽查,问题往往事后才发现;纸质报告也很难追溯和统计。
产品负责人,负责阳光厨房与智慧养老两条产品线。
覆盖人员违规、行为分析、消防安防等 20 余类识别任务,自动完成异常分析、报告生成和任务派发。方案标准化后,复用到了 3 个同类项目。
厨房和养老看起来是两个行业,底层却是同一条链路:发现问题、判断问题、提醒处理。看清了这条链路,换场景时改的是识别任务和报告模板,主干不用动。
行业知识库很容易做成摆设:资料堆进去了,问答时好时坏,演示时很漂亮,业务人员却不愿意天天用。水利行业的资料多、专业、更新频繁,这个问题更明显。
主导项目交付,从方案设计跟到交付,同时负责 LLM 问答和 RAG 知识库的能力建设。项目合同为百万级。
LLM 问答、RAG 知识库这些能力,我后来和感知、分析、告警、交互、运维等共性需求放在一起,整理成了 8 个标准化模块,供各项目复用。
这是一次方案推演,写的是思路,不涉及具体项目数据。
热线工单的特点是量大、诉求重复度高,但长尾很长。全部交给大模型,成本和时延都扛不住;全部交给规则或小模型,疑难工单又会被分错部门,来回流转。
教会系统说"我不确定"。模型天然倾向于给出一个答案,哪怕它没把握。所以要单独评测置信度是否可信:高置信度的样本里,分错的比例有多少。这个数不过关,分层就没有意义。
这是一次方案推演,写的是思路,不涉及具体项目数据。
关键词规则能抓住"违约金""管辖"这类显性条款,抓不住"这条写得有点怪"。法务看合同时最有价值的那句"感觉不对",规则写不出来。
在模型之外。和法务一起把"感觉不对"拆开,会发现大部分直觉都能落成具体的检查项:比如责任上限被改了、付款节点被挪了。拆得越细,规则库越厚,LLM 需要兜的部分就越少。
用 AI 编程工具自己做出来的东西:三个能直接打开的原型,一个能玩的游戏,两部 HTML 短片。
方案讲不清的时候,我就做一个能点的。
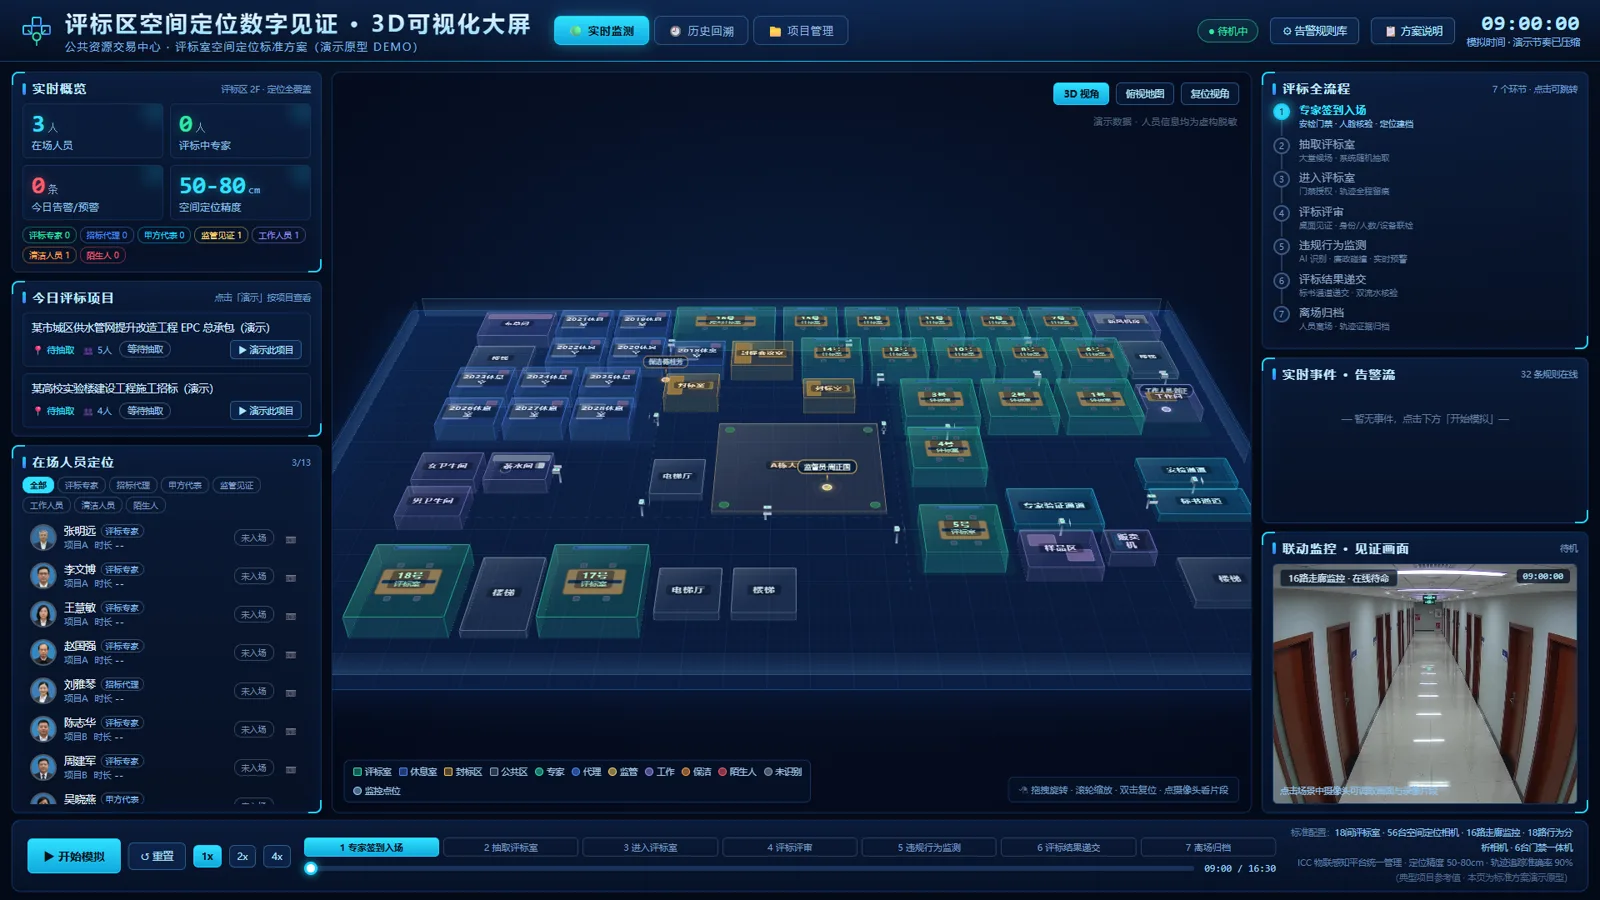
18 间评标室、56 台定位相机、32 条告警规则。人员定位、历史回溯、联动监控,都能直接点开看。
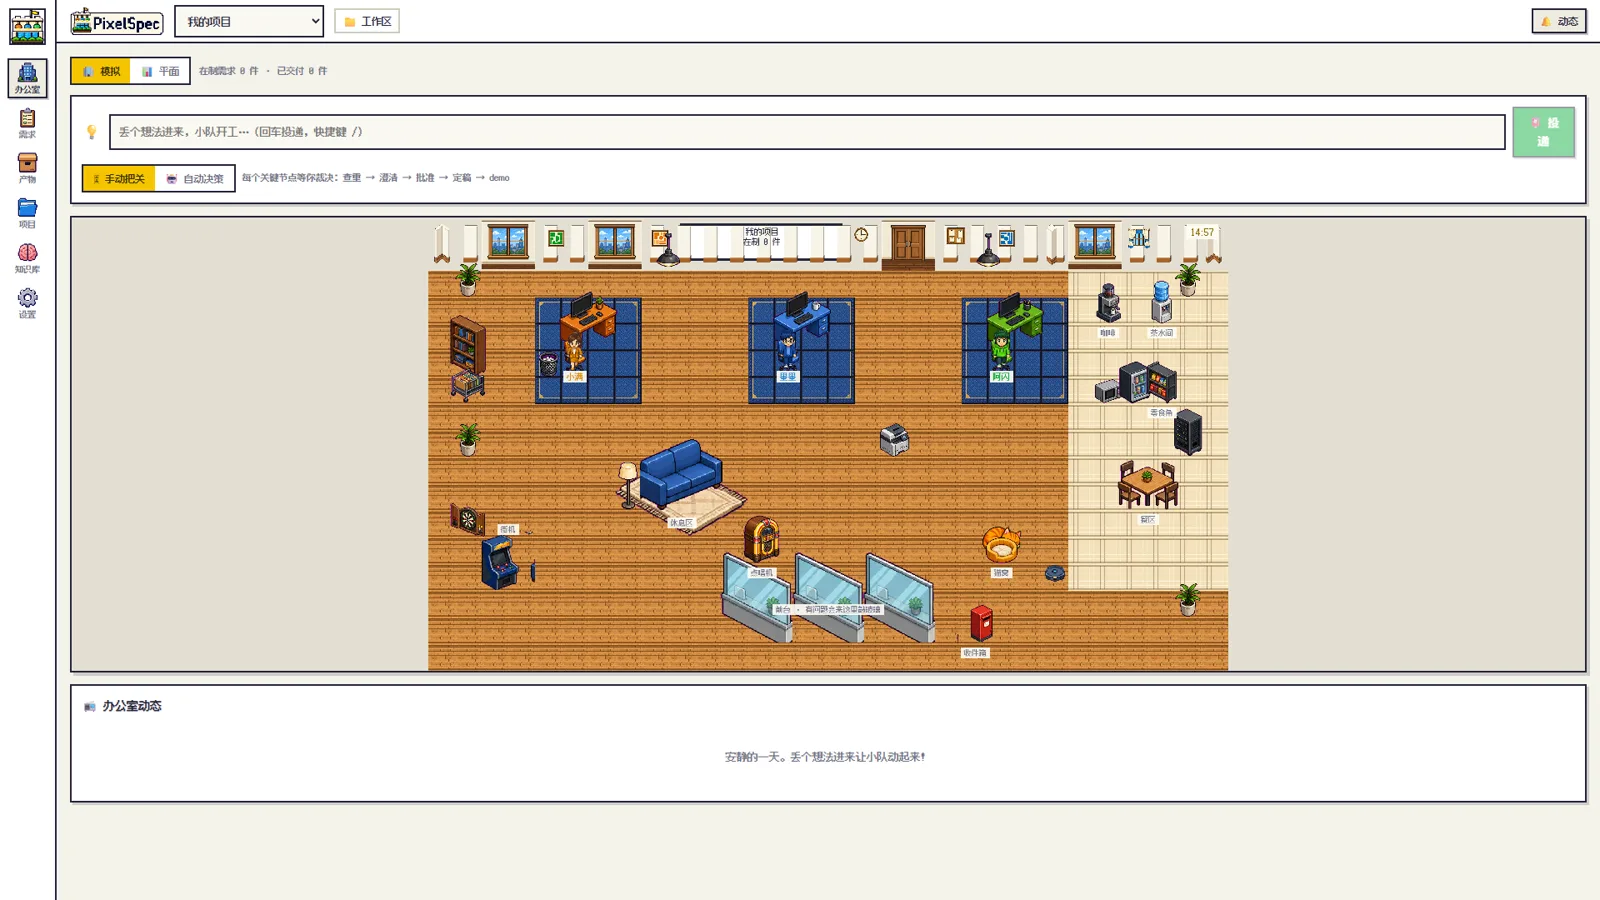
小满查重与澄清,墨墨定稿结构化 Spec,阿闪产出能试用的 Demo,关键节点由我确认。输入一句需求,输出 Spec 文档和可运行的 Demo。
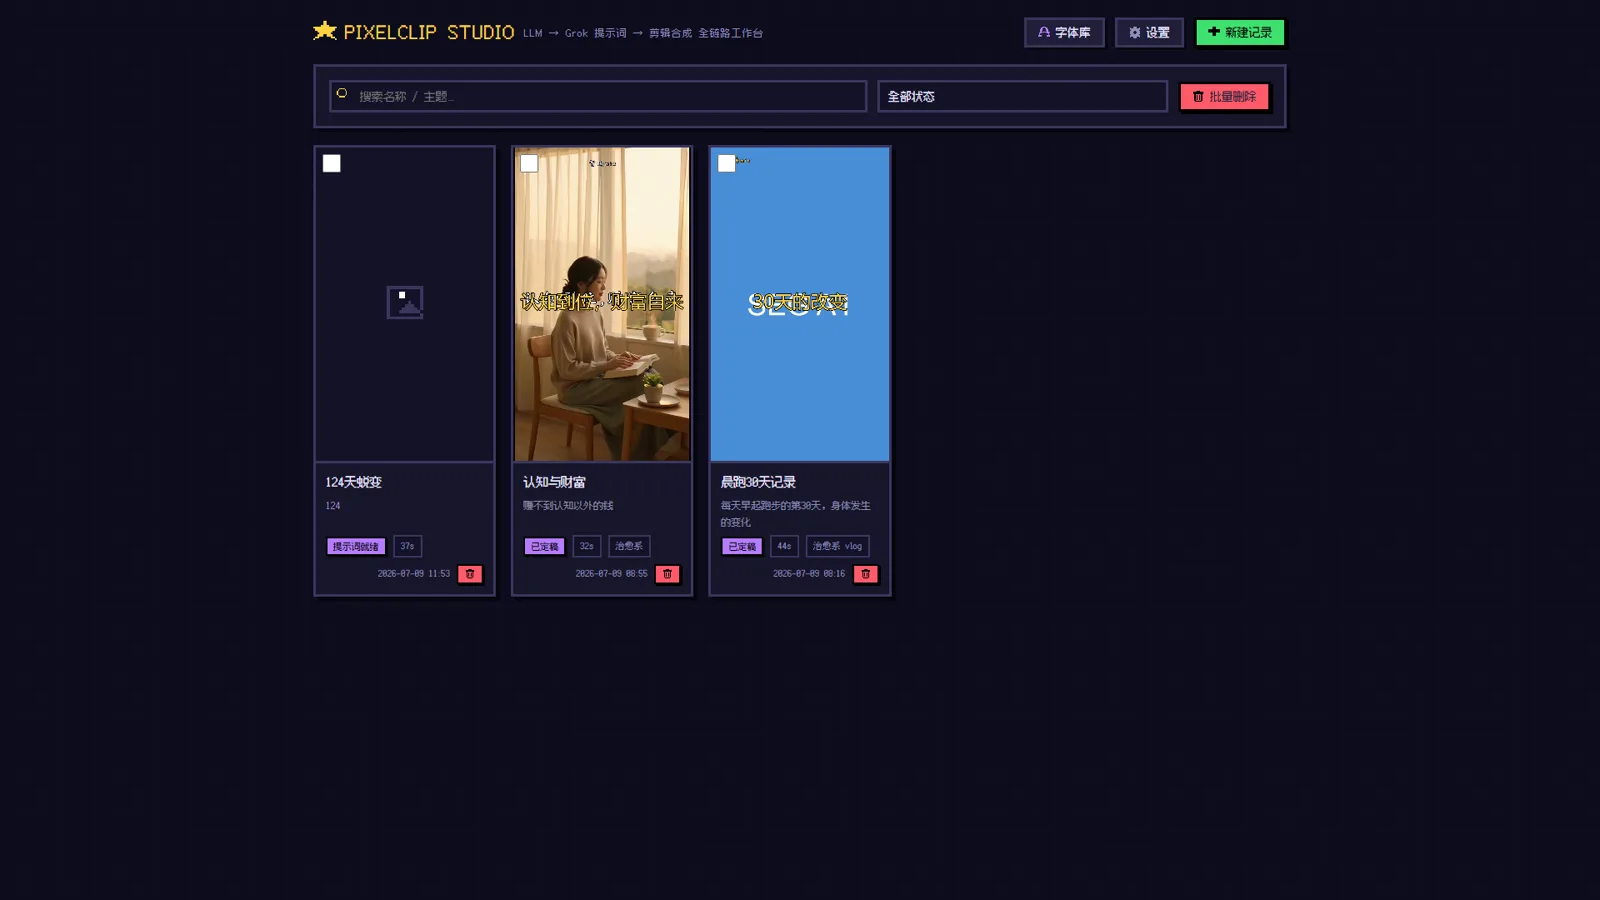
输入一个主题,依次生成文案、分镜、TTS 配音、字幕和 BGM,合成一条完整的短视频。散落在七八个工具里的活,收进一个像素风工作台。
悬停看预告,点开拉幕。每部都附了一篇制作手记。
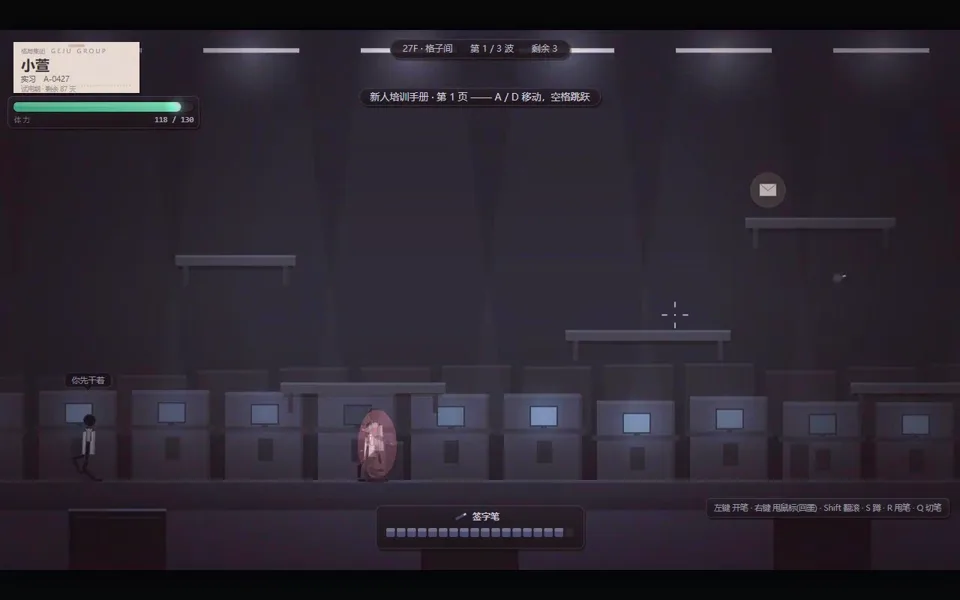 可试玩
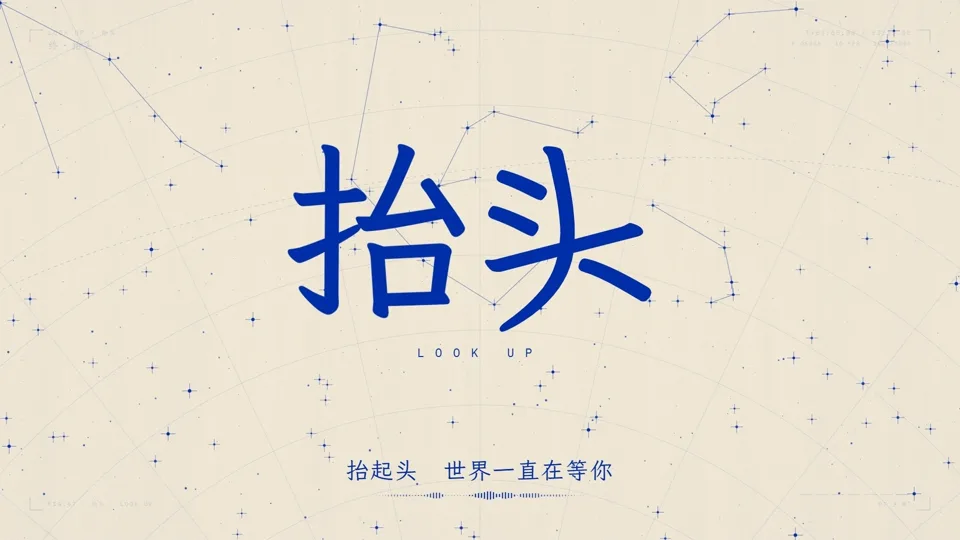 放映
 放映
一个产品经理用 AI 编程工具做出的横版动作游戏:玩法、剧情和手感取舍都在这里。
一部用代码"拍"出来的 3 分钟短片:从一条时间线,到双色画面、手写字幕和原创配乐。
把视觉识别的日常工作讲成一部短片。第一版做得像仪表盘,被我自己否掉了。
评标室空间见证这类方案,文档写得再细,评审时大家脑子里也很难同时装下 18 间评标室、56 台定位相机和 32 条告警规则。与其讲,不如让人直接点:人在哪间屋、触发了哪条规则、回溯时轨迹怎么走。
从一份标准方案文档出发,先把文档里的对象、规则和流程整理成数据,再用 AI 编程工具搭出可交互的大屏。数据全部是虚构的,结构和规则来自方案本身。
需求从一句模糊的想法,到一份能开发的 Spec,中间要来回澄清很多轮。我想试试:如果把这个过程拆给几个 AI 角色,我只在关键节点拍板,会怎样。
每个角色交棒前,都停下来等我确认。输入一句需求,最后拿到一份 Spec 文档和一个可运行的 Demo。整个工具本地优先,资料不出本机。
三个角色坐在一间像素风办公室里,谁在干活、卡在哪一步,一眼就能看到。多 Agent 协作最怕"黑箱",把过程画出来,比写一堆日志更直观。
做一条短视频,要在七八个工具之间来回切:写文案、拆分镜、配音、对字幕、找音乐、做封面。每一步都不难,难的是串起来。
所有步骤收进一个像素风工作台,每一步的中间产物都能看、能改,改完从这一步往后重跑。
一个横版动作游戏,题材是打工人。纯 HTML5 Canvas,零依赖、零构建;美术全部用代码程序化绘制,音效由 WebAudio 合成。五个上司,五场 Boss 战,还有无限加班模式和更衣室。
和 AI 编程助手一起,从玩法设计文档、剧情设定写起,再一个系统一个系统地实现:角色、Boss、关卡、存档。测试靠在浏览器控制台里逐帧驱动游戏,验证每个机制是否按设计生效。
"打起来爽不爽"。AI 能很快写出能跑的战斗系统,手感却只能自己一遍遍玩出来。这一项我还没调完,算是下一版的功课。
从 8 月 11 日到 9 月 29 日,几款 AI 产品先后走进我的生活:Grok Bot、Muse、Jev、Cue、Dots。前后相隔四十九天,正好是七个七天。片子沿着这条时间线走,穿插了卡尼曼、杰文斯、帕斯卡、康德等人的观点,最后落在一句话上:让机器低头工作,让人抬头生活。
只用两种颜色:米黄和克莱因蓝。字幕用霞鹜文楷手写体。"头"这个字是全片的母题,会倾斜,也会上扬。
整部片子是一个 HTML 页面,用代码"拍"出来:
选什么讲、讲到哪里停。时间线上的事件很多,哪几件值得进片子、落点那句话怎么说,这些只能自己定。
一张监控图片,怎样一步步成为解决问题的起点:从视觉识别,到大模型,再到本地部署。素材来自林区、水利、园区这几类我熟悉的视觉识别业务,全片 8 章。
第一版做成了仪表盘的样子:卡片、胶囊、顶栏,一屏一屏都像产品界面。看完觉得不够高级,整版推翻,改成编辑电影的风格:全屏网点照片,粗细字重的强对比,整屏深松绿的章节卡,细线分隔,去掉所有 UI 装饰。
画面素材先用 AI 生图,再转成双色网点;检测框按照片坐标逐个标定。管线沿用了《抬头》的那一套。
判断"不够高级"。AI 可以很快把第一版做出来,但要不要推翻,只能自己拍板。
产品经理,AI 应用实践者,复盘的忠实信徒。
2017 年在京东做智能客服和 NLP;2019 年到一智科技,把智慧工地监管平台从 0 做到 1;2021 年起在大华做公共领域的 AI 产品,从森林防火、草原做到水利和食安养老。
比起一串头衔,我更相信经历是一次次具体的解题。所以这里主要写复盘:当时的约束是什么,我怎么理解场景,哪些判断被验证了,哪些摔了跟头。比如这篇:Hermes 报警研判 →
工作之外,我在路上。去过 18 个地方,家里有两只狗、一只猫,偶尔找家咖啡馆,把买回来的书读完。
设计意图识别体系和 5 大 BU 路由策略,问题匹配准确率 88%;3 个月上线,日均处理咨询 10 万+。
监管平台和配套终端从 0 到 1,单品毛利率 45%;对接 7 个省市住建主管单位,推动 3 个地市政策试点。
森林防火、草原、水利、食安养老;主导两个百万级项目,把共性需求整理成 8 个标准化模块。
两种节拍,都是我认识世界的方式。
工具、模型和方法。每篇都从项目里的一个具体问题出发。
四家都订了:Grok Bot 跑日常、出视频,Claude 管核心产出,GPT 做调研和补位,Gemini 看病、管资料。用久了发现,它们更像四个性格完全不同的同事。
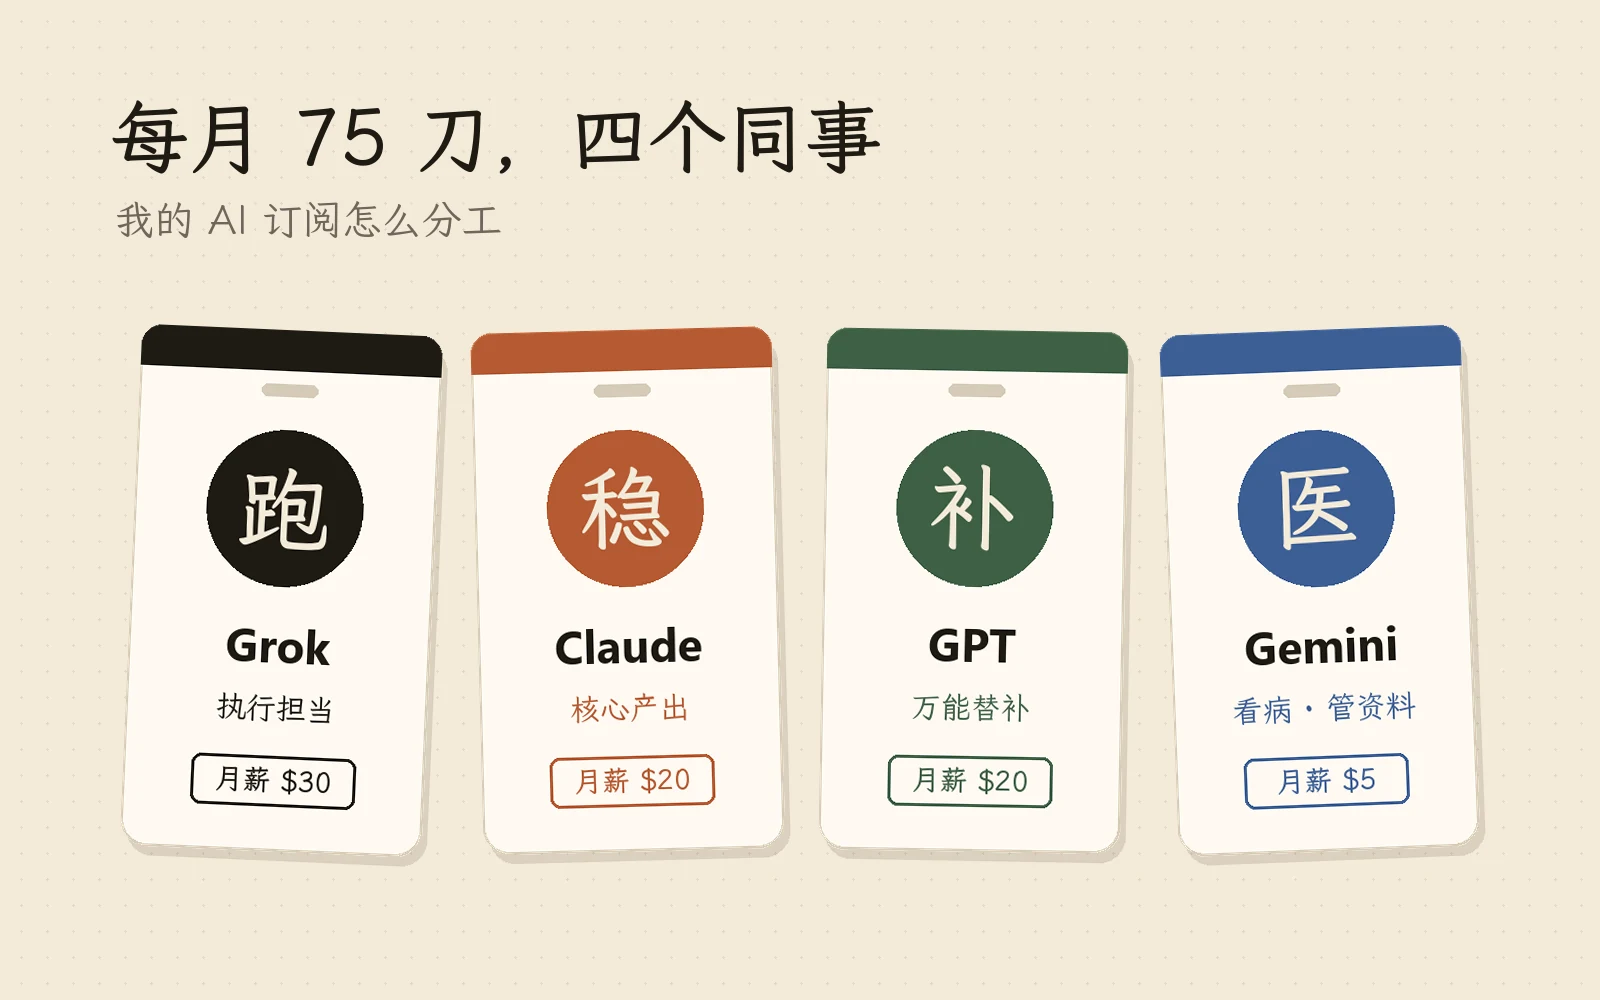
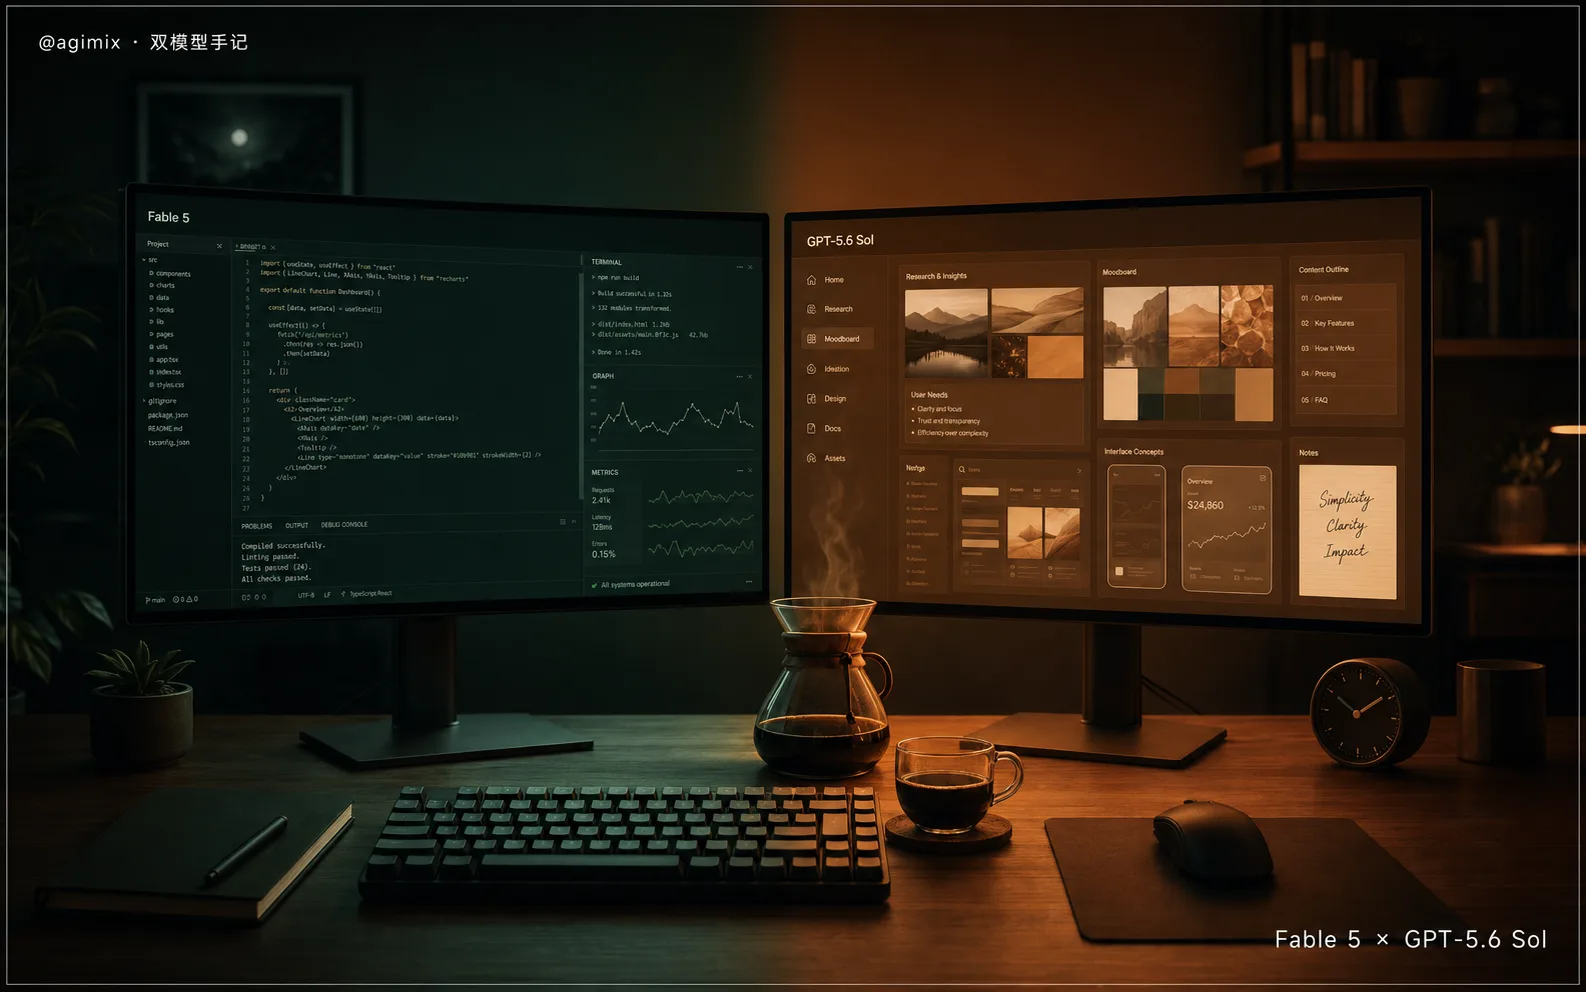
一个胜在严谨的工程闭环,一个赢在天马行空的生成手感。我给两个模型定了分工规则:谁写代码、谁做创意、什么时候果断换人。
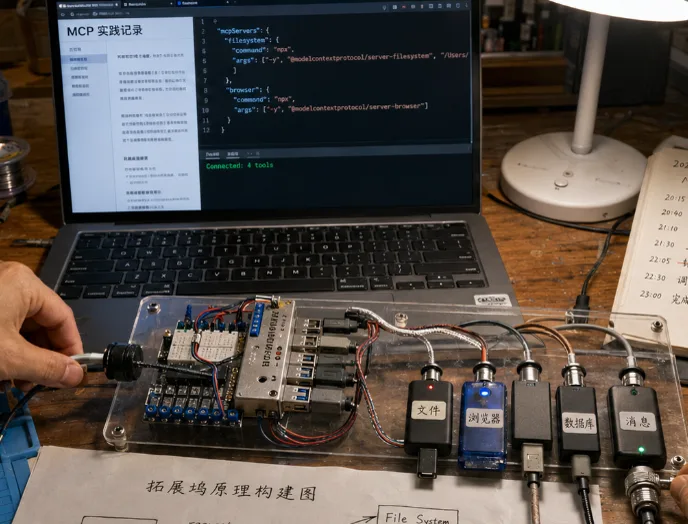
让模型直接读我的文件、查我的数据、调我的脚本。上手路径、安全边界,以及一个预感:工具生态的迭代速度,可能比模型本身还快。
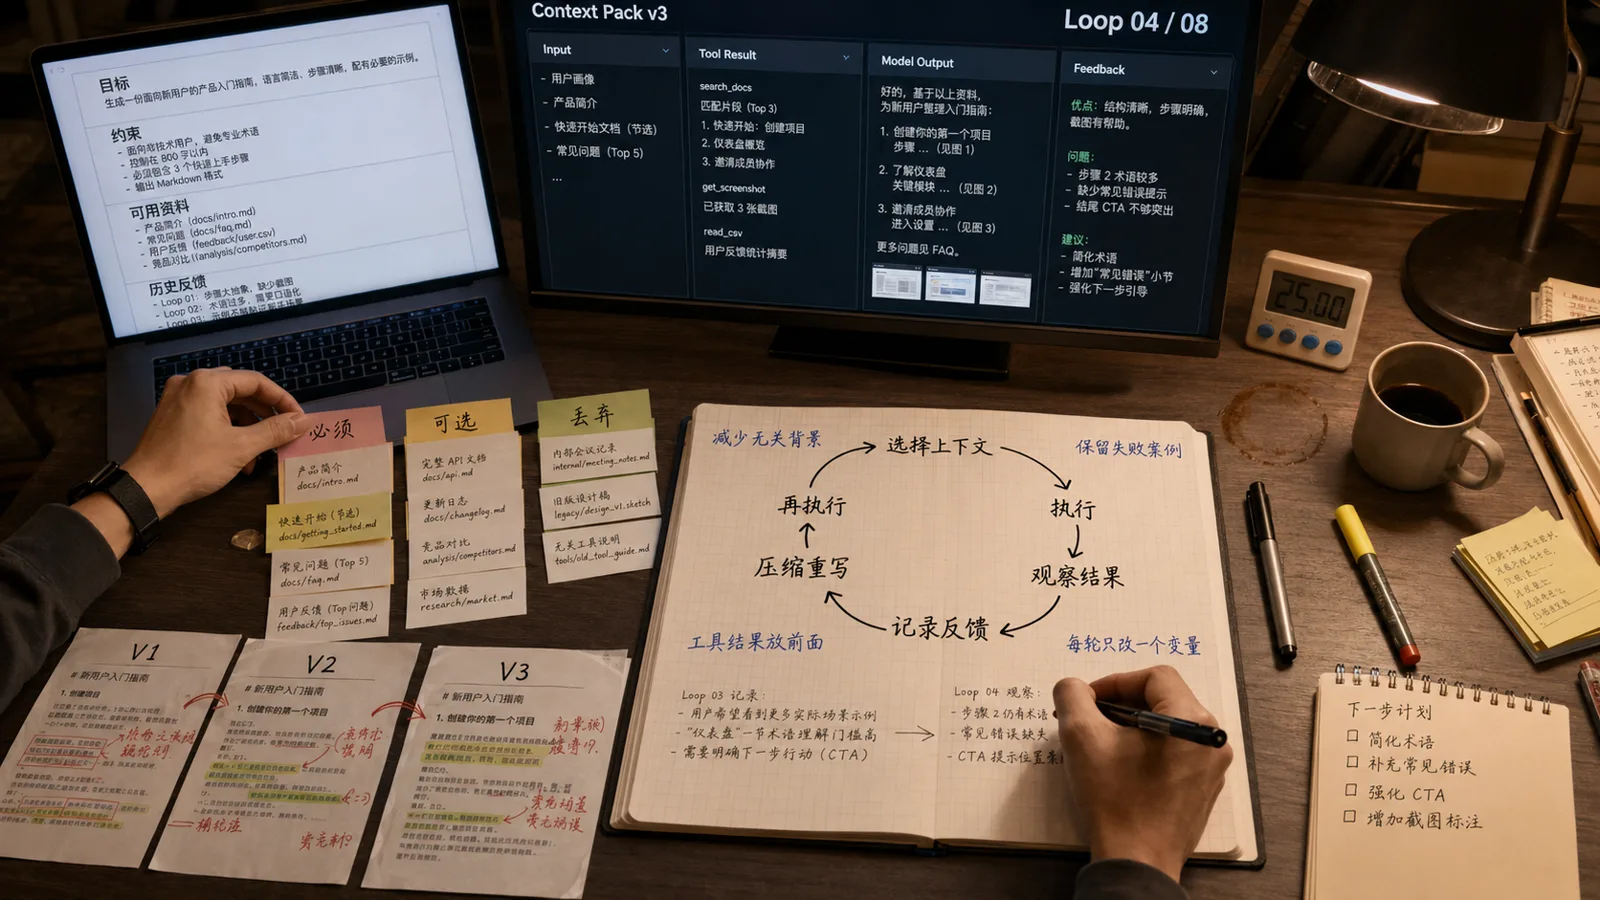
提示词写得再花哨,也救不了塞错上下文的对话。我管理上下文的几个习惯:该塞什么、塞多少、什么时候清场重来。
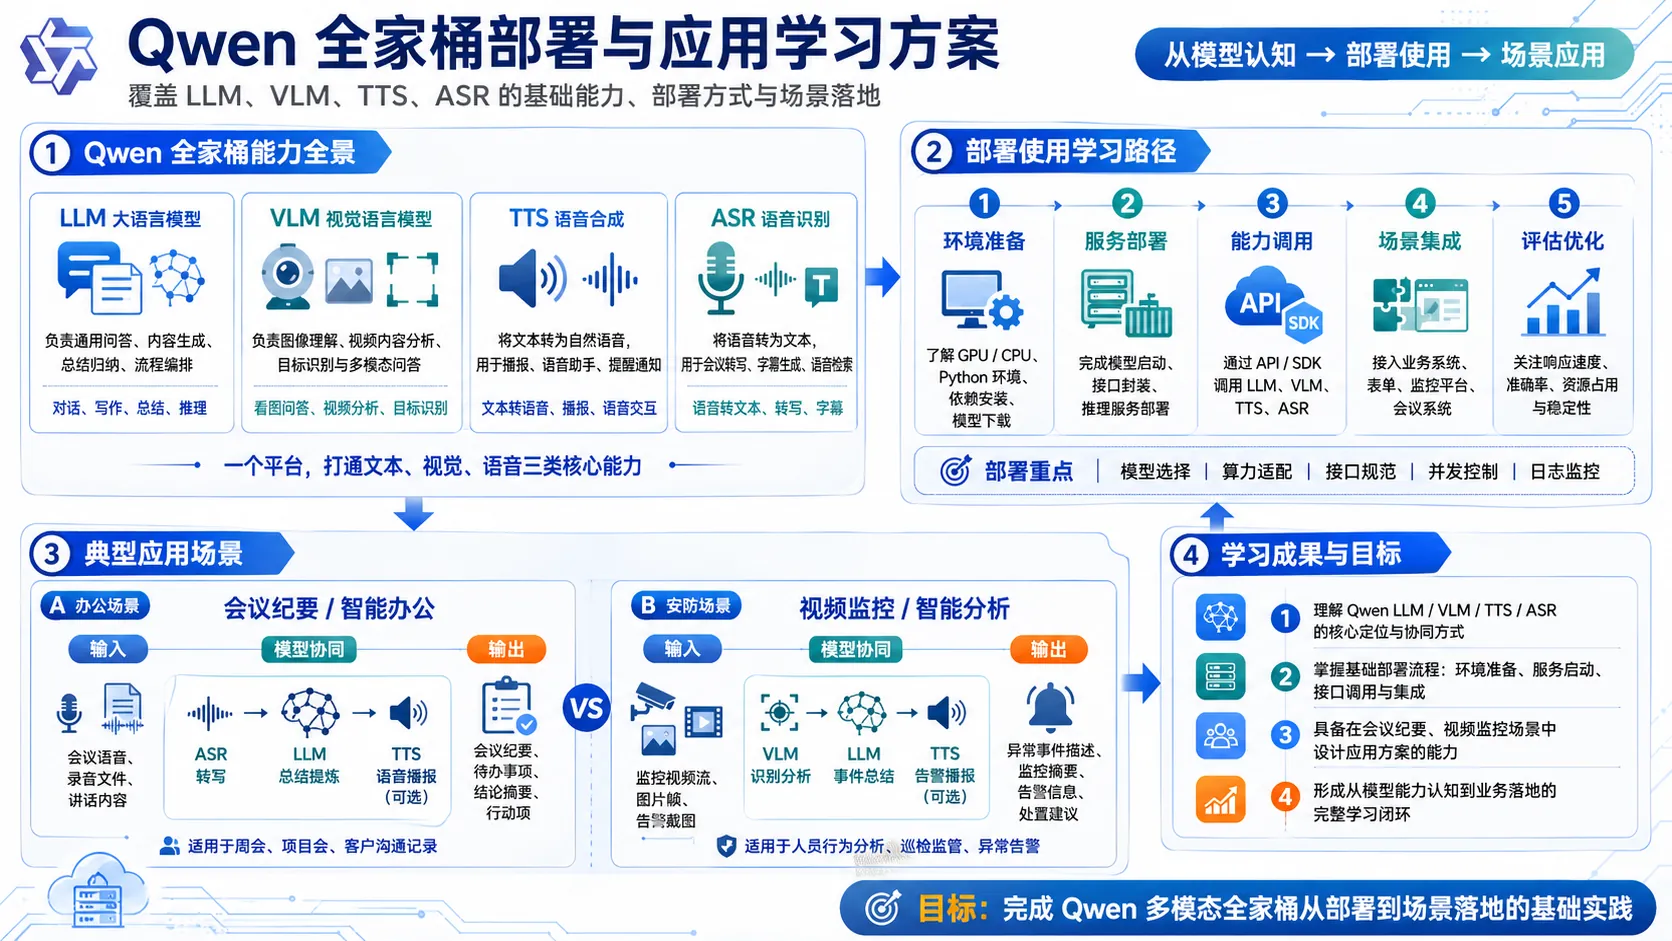
LLM、VLM、ASR、TTS 各管一摊。私有化部署时要算清楚的账,以及怎么把几个模型组合成可复用的产品能力。
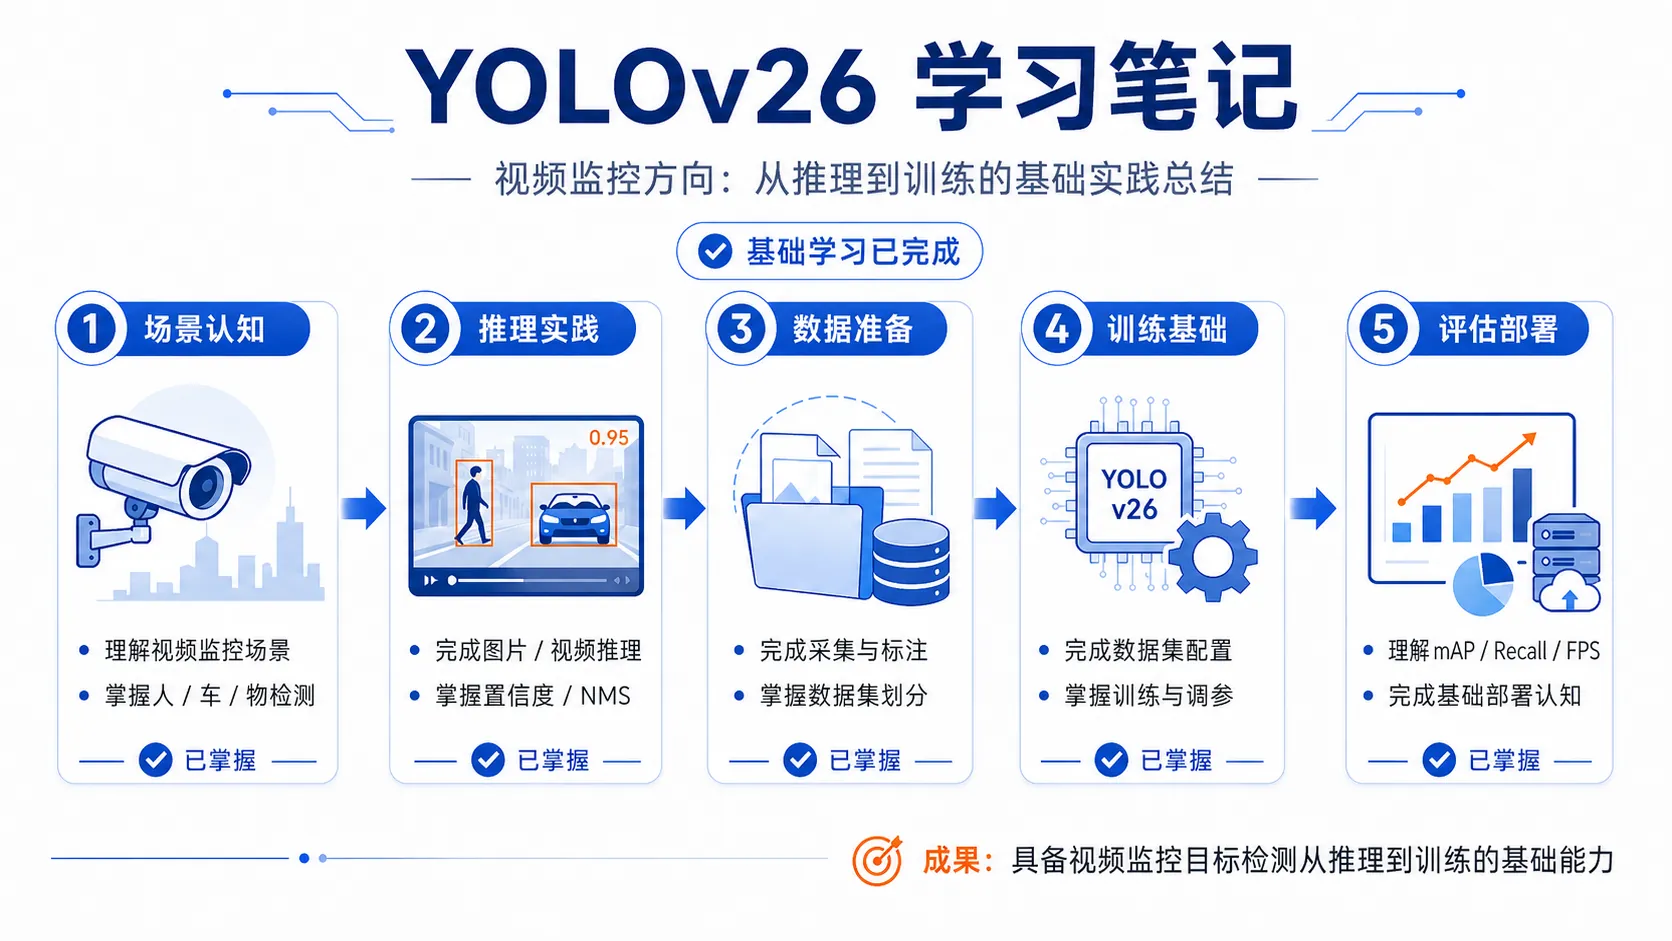
大模型在部分场景准确率不够,需要 YOLO 这类检测模型补位。我的学习路径:先跑通推理,再弄懂数据、标注、训练和效果验证。
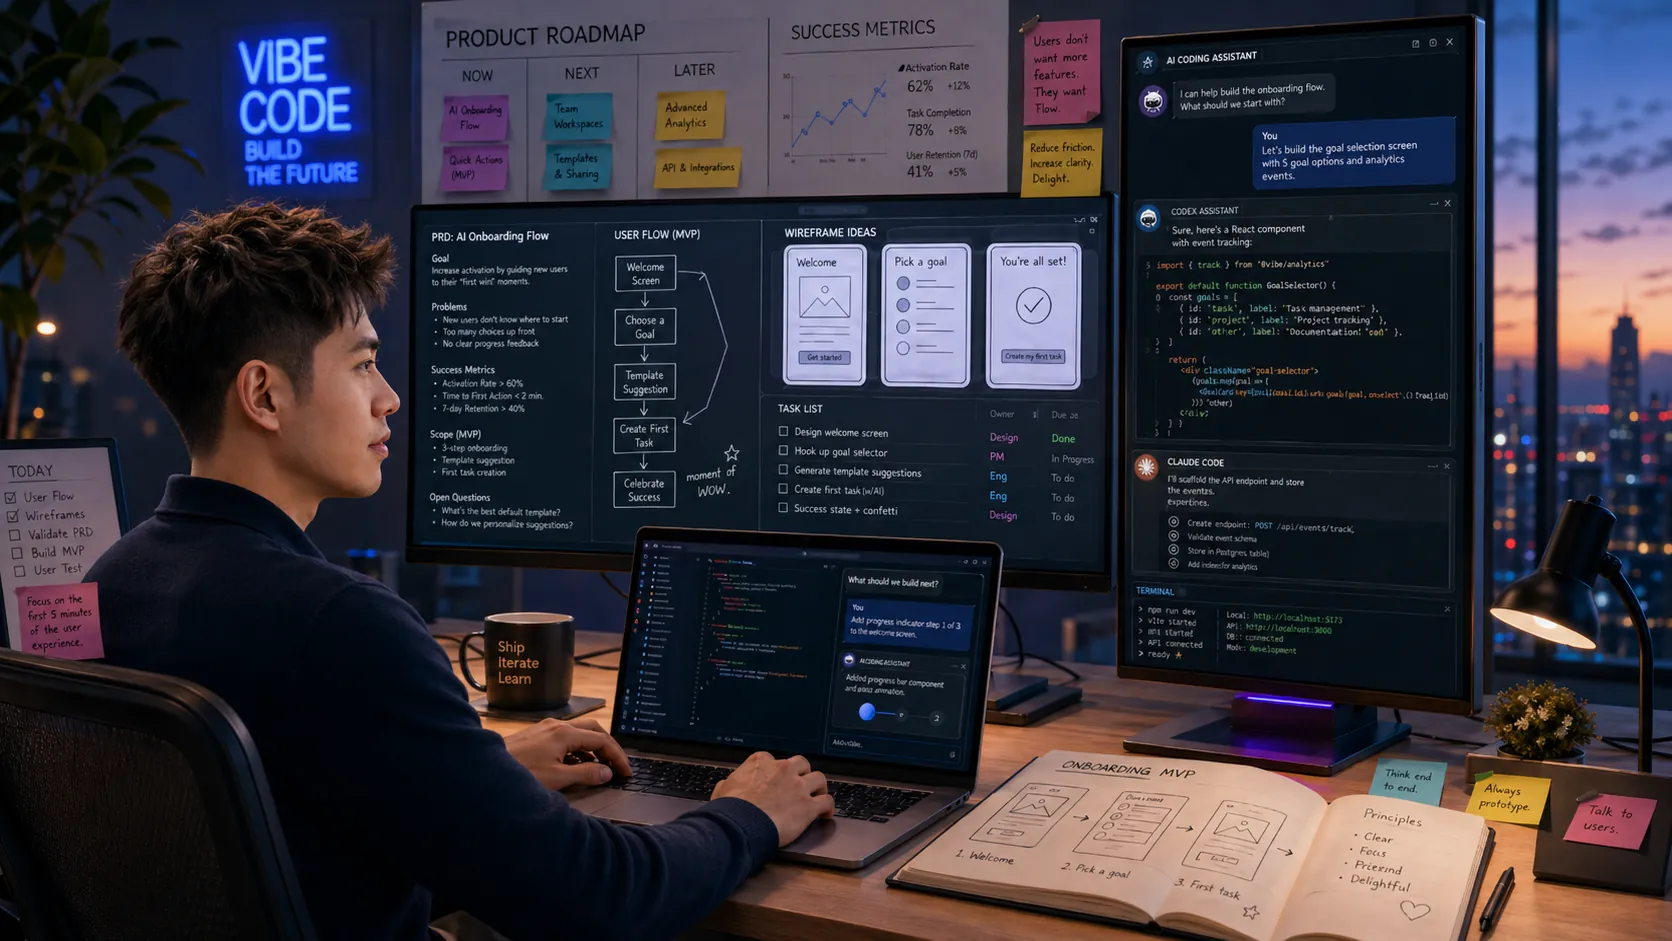
从没有代码经验开始,用 AI 辅助完成需求拆解、界面搭建、功能调试和部署上线。这个网站、《办公室快打》和几个原型,都是这么做出来的。
节点越大,关联的项目和文章越多。点一下节点,看它连着哪些内容。
用久了,我慢慢摸清了它们各自的脾气:谁什么活都肯接,谁最靠得住,谁哪里缺人补哪里,谁敢把话说透。
什么活都肯接的那个。
团队里最靠谱的那位。
哪里缺人,就补哪里。
最出乎我意料的那位。
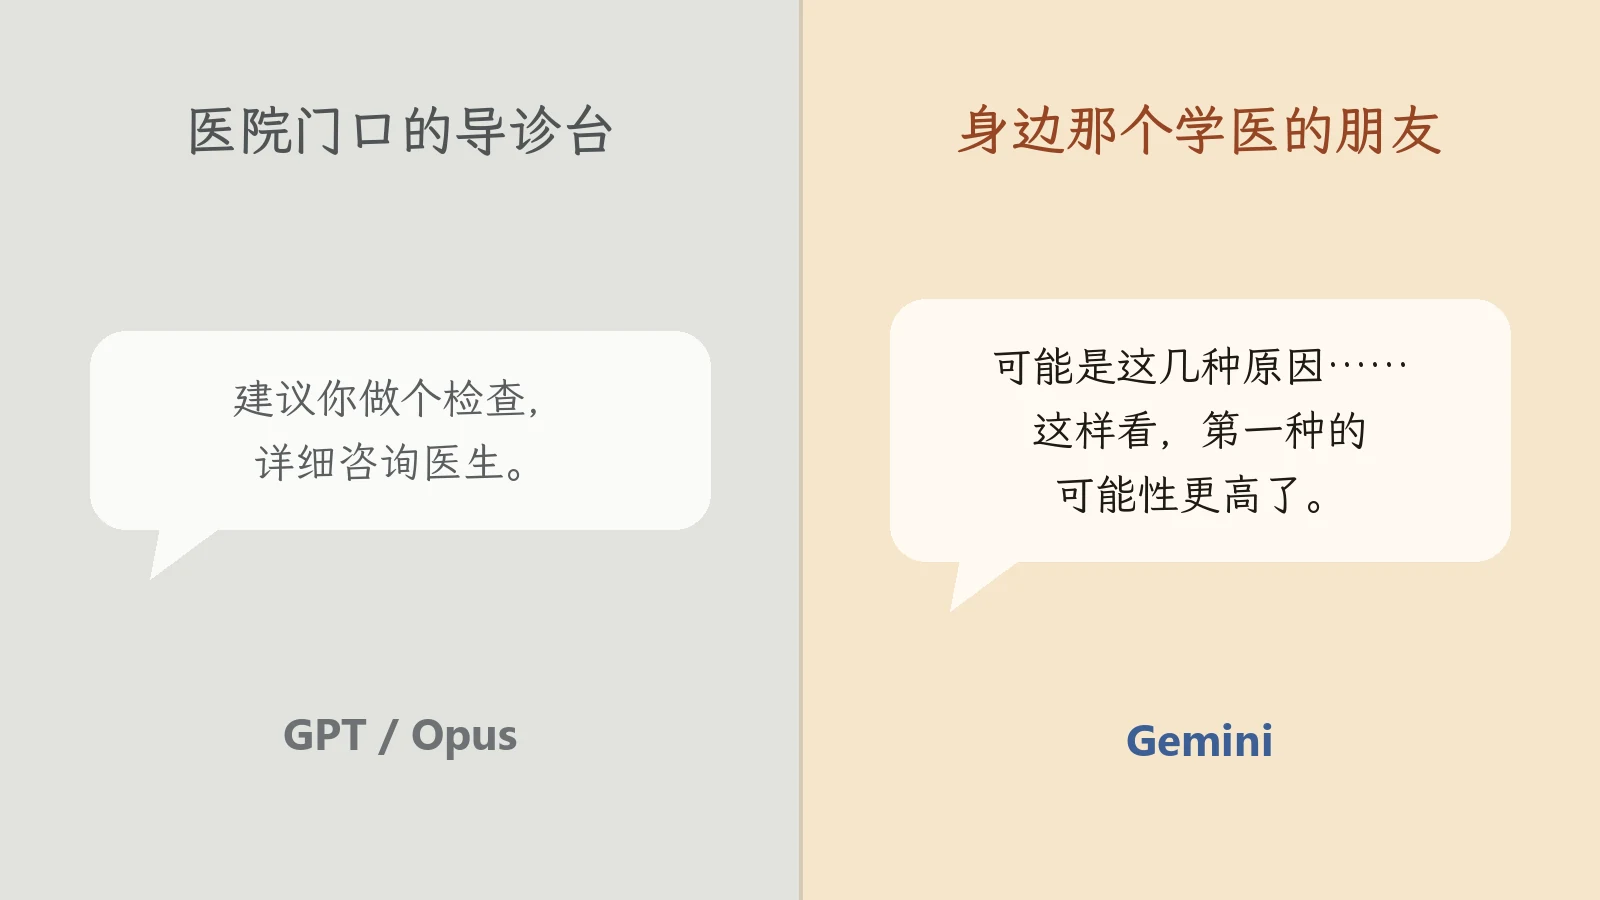
身体不舒服的时候去问 GPT 和 Opus,得到的基本都是"建议你做个检查,详细咨询医生"。话没错,但跟没说一样。
Gemini 不一样,它敢直接告诉你"可能是这几种原因"。我把症状和检查结果一点点补给它,它会说哪种可能变大了,或者提醒我该往别的方向想。再加上它背后是 Google 那一整套搜索,查到的东西也更靠谱。
建议你做个检查,详细咨询医生。
② 补充检查结果还是建议你做个检查,详细咨询医生。
可能是这几种原因:……
② 补充检查结果这样看,第一种的可能性更高了;也有另一种可能,要往这个方向再看看……
如果说 GPT 和 Opus 像医院门口的导诊台,Gemini 就像你身边那个学医的朋友,愿意跟你把话说透。
看病那部分是我的个人体验。AI 的判断我只拿来做就诊前的准备,最后还是听医生的。
同一个任务,两个模型给出的东西风格差别很大。与其每次凭感觉选,不如并跑一段时间,把分工规则定下来。
一套让大模型调用外部工具的通用协议。工具按约定写成一个 server,模型就能读文件、查数据、执行脚本,不用每接一个工具都重新开发一遍。
能读的范围、能写的范围、哪些操作要确认,在接入前就写清楚。工具接得越多,这件事越重要。
提示词写得再花哨,也救不了塞错上下文的对话。模型能做多好,很大程度上取决于它看到了什么。
宁精勿多。无关的材料会稀释注意力,让模型在不重要的地方用力。
对话跑偏、约束被遗忘、来回修补越补越乱的时候。先让模型总结当前进展和约束,再带着总结开一个新对话。
单个模型解决单个问题,组合起来才是产品能力。比如 ASR 加 LLM,就是会议纪要;VLM 加 LLM,就是"看图说话"的巡检研判。
大模型在部分场景准确率不够,需要 YOLO 这类检测模型补位:快、轻、对固定目标稳定。产品经理懂一点检测模型,和算法同事讨论数据和指标时,能少很多鸡同鸭讲。
模型效果的上限,大多在数据那一步就定了。标注口径不统一,训练再久也是在学噪声。
我没有写代码的经验。这一年里,用 AI 编程工具做出来的东西,就摆在这个网站上:网站本身、《办公室快打》、PixelSpec、PixelClip、评标室 3D 大屏原型,还有两部 HTML 短片。
方案讲不清的时候,可以直接做一个能点的原型。和研发、和客户沟通时,一个能跑的东西,比十页文档更有说服力。
亲手试过的 AI 新产品。每则写四件事:试了什么、结果、我的判断、还会不会用。
加班间隙把视频输出功能从头试了一遍。想法第一次这么快有了画面,接下来要看它能不能稳定地用进作品里。
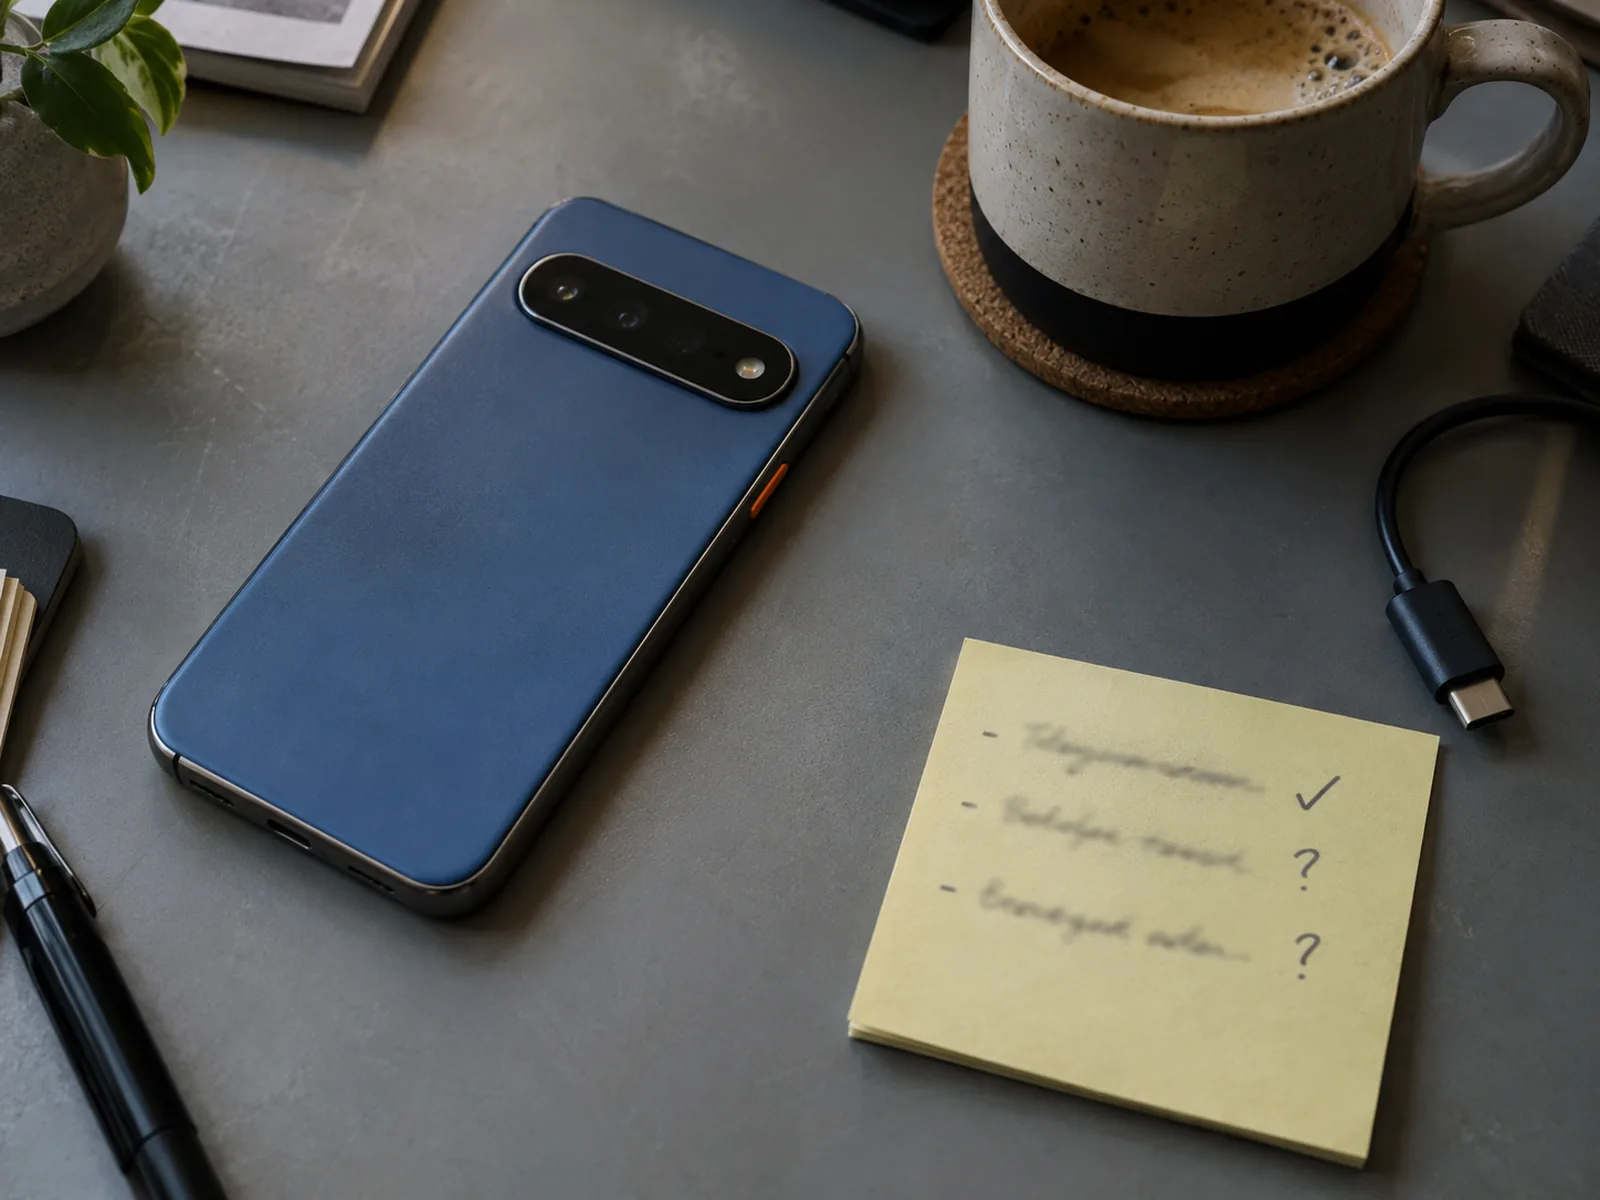
国庆第一天入手,专门测了手机 Agent。能演示出来的能力,和愿意天天依赖的体验之间,还隔着一段路。
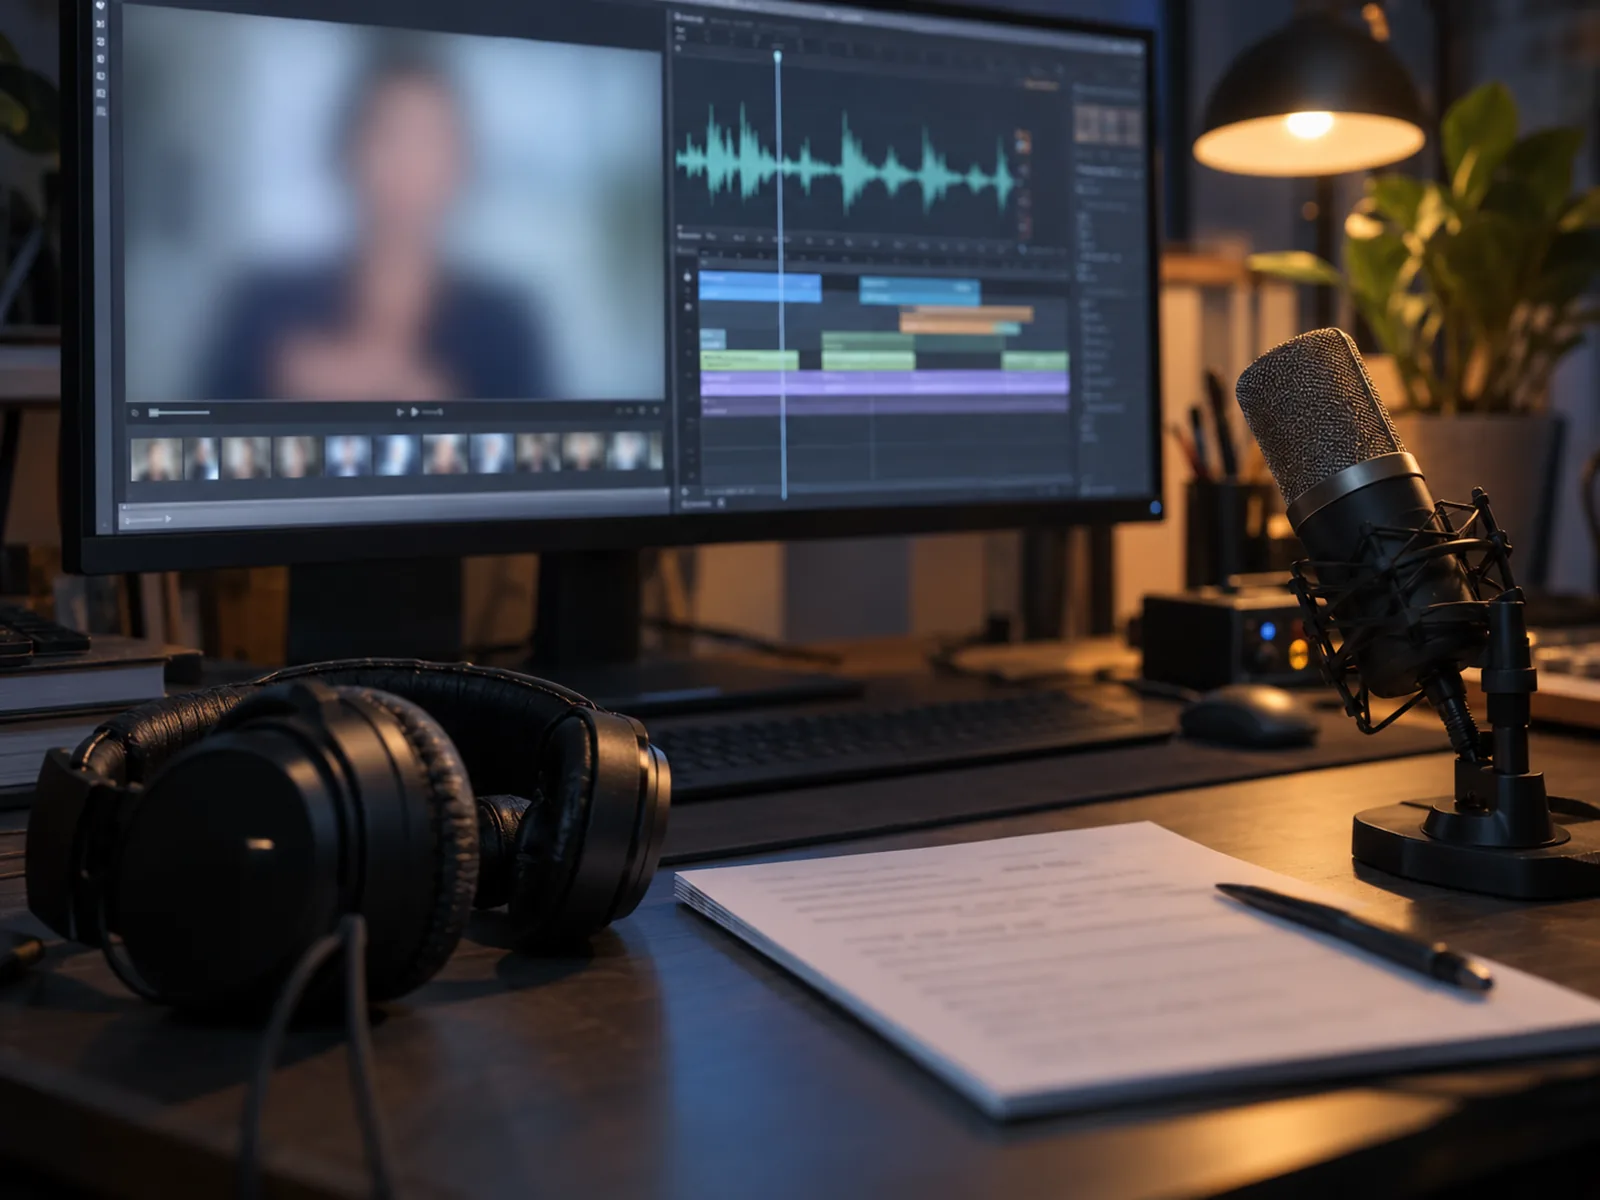
Kits 做 AI 歌曲,HeyGen 做数字人。两样串起来,最后真的用进了公司的采访场景。
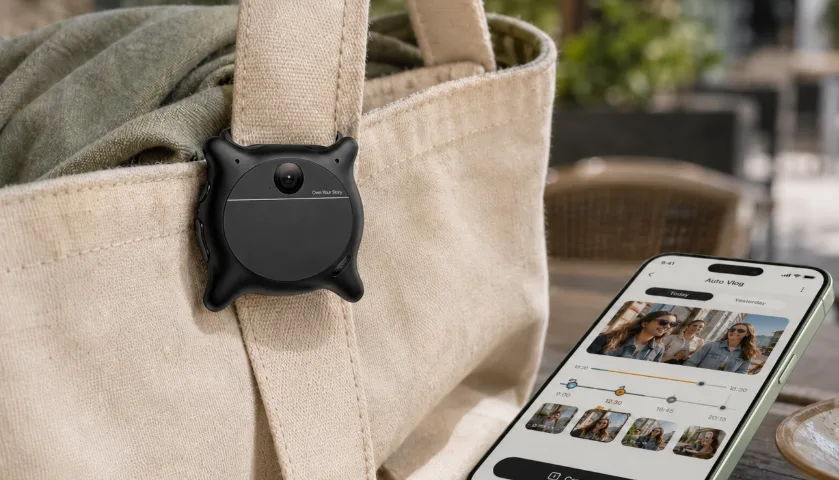
素材自动整理、日常自动成片,思路很讨喜。顺手把体验过程录了屏,偷师了不少交互细节。
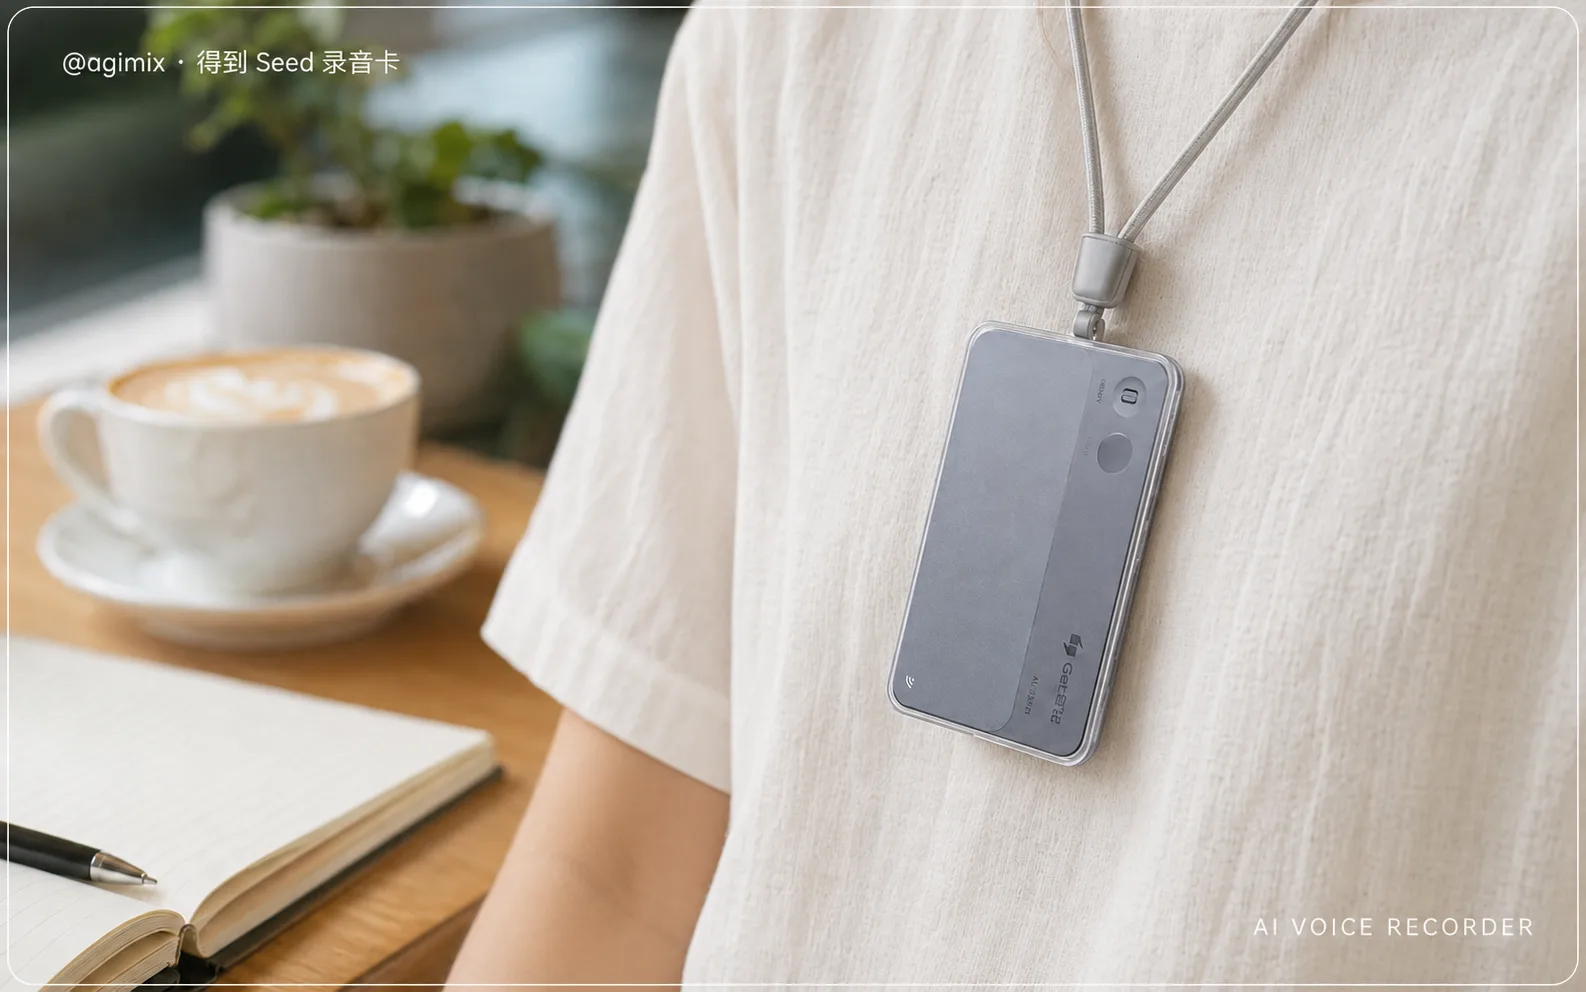
开会、散步、开车时的碎碎念,回来自动变成文字稿和待办。以前的灵感是"回头再说",现在是"已经记下"。
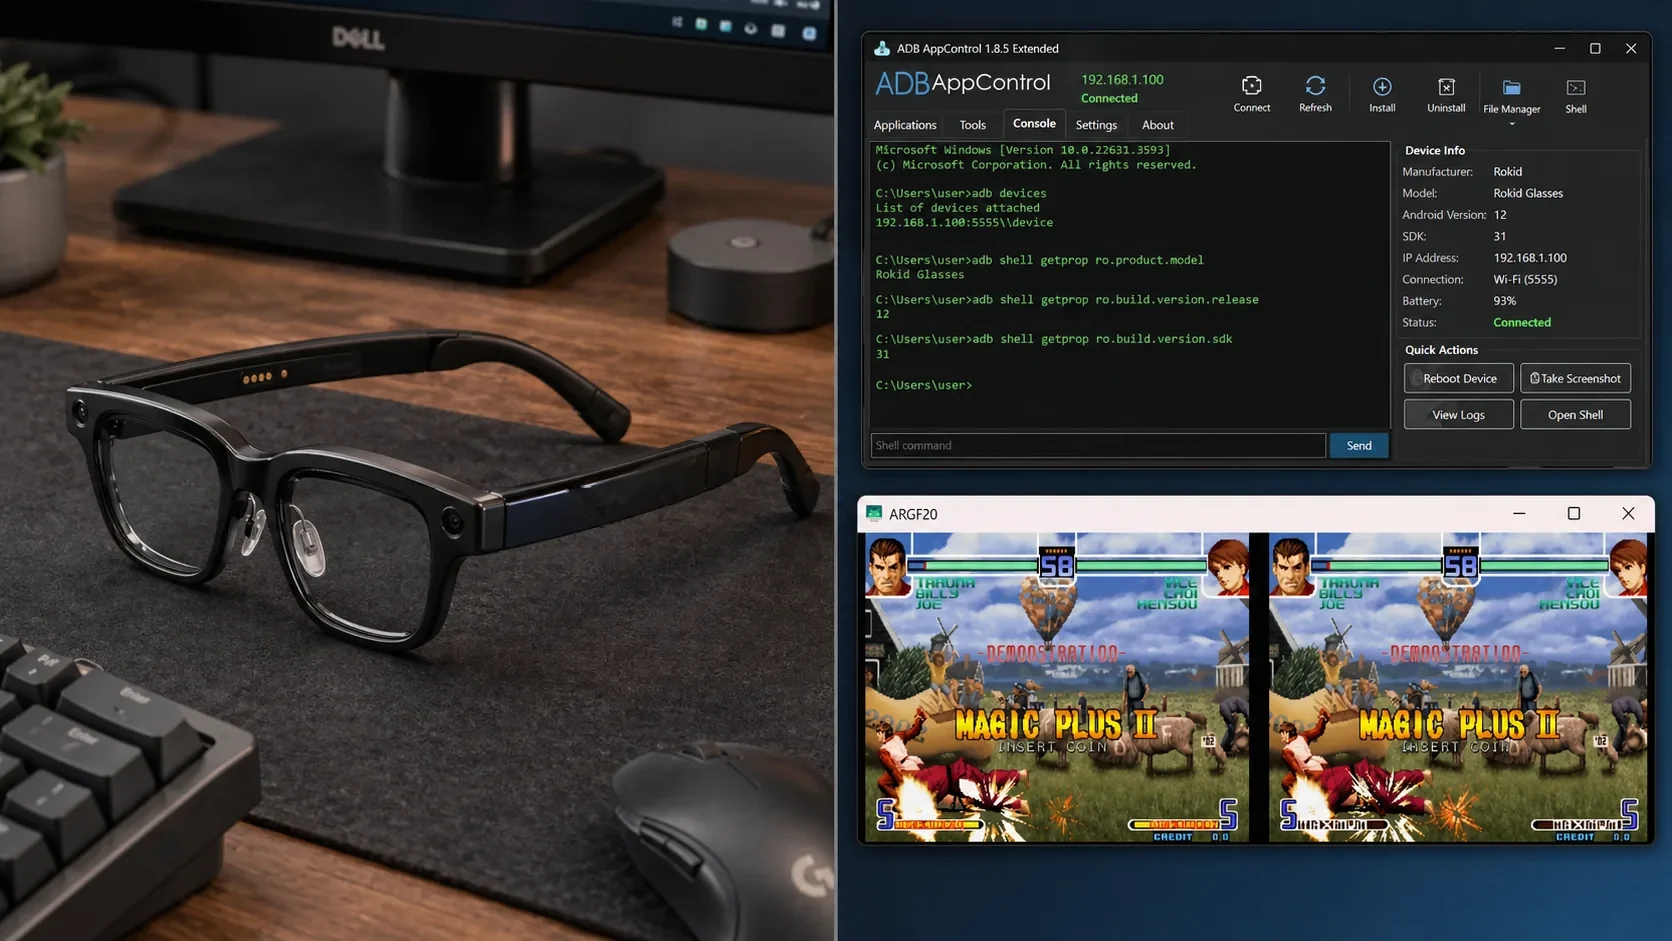
眼镜会不会成为下一个手机?不知道,但可以先亲自开发、亲自调教。用 Vibe Coding 适配了游戏模拟器,把儿时的快乐找了回来。
10 月 7 日来公司加班,工作间隙顺手把 Opus 5.5 输出视频的功能探索了一遍。原本只是一点好奇,结果又进入了熟悉的状态:想试的越来越多,下一个念头好像也值得做出来看看。
当想法开始有了画面,那种惊讶很难用参数说明白。最贴近当时心情的,大概就是一句:「20 刀,居然可以与上帝对话。」带点夸张,也带点真心。
10 月 1 日,买了刚发布的豆包手机。侧边那颗橙色的 AI 键一按,就能把事情交给它。对手机 Agent 好奇了很久,这次终于能放进自己的日常里实测。
实测下来,效果和真实场景的需求相差还是比较大。先把这一次记下来,保持好奇,也把期待放回实际使用里。
8 月 15 日,记一下最近的沉迷对象:Kits 和 HeyGen。单独玩哪一个都有意思,放在一起,就很难只停在「试一下」。
学新工具最快的时候,往往就是手上正好有件想做的事。
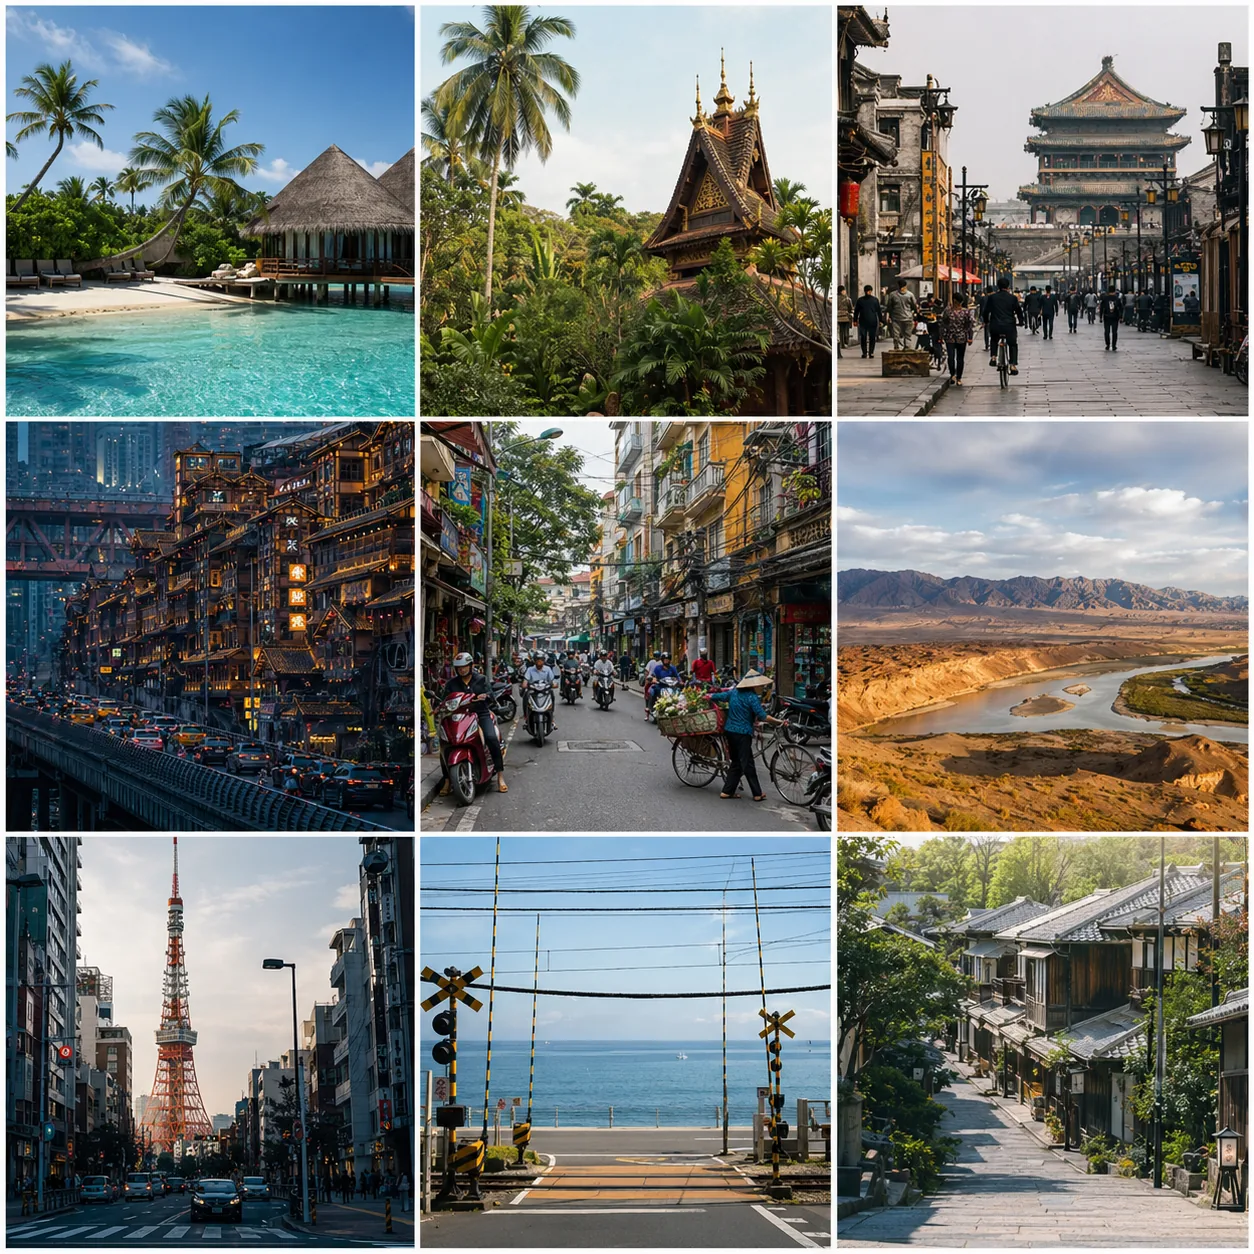
人生如逆旅,我亦是行人。
18 个地方,44 张底片。从冰岛的黑沙滩、挪威的峡湾与极光,到曼谷寺庙和湄南河的夜色。比起景点,我更记得某个傍晚忽然松下来的那口气。
点地图上的城市,看那里的照片;也可以在下面的胶片里按地方筛选。
点开放大 · 可按地点筛选
大模型之外,留给自己的几件小事。
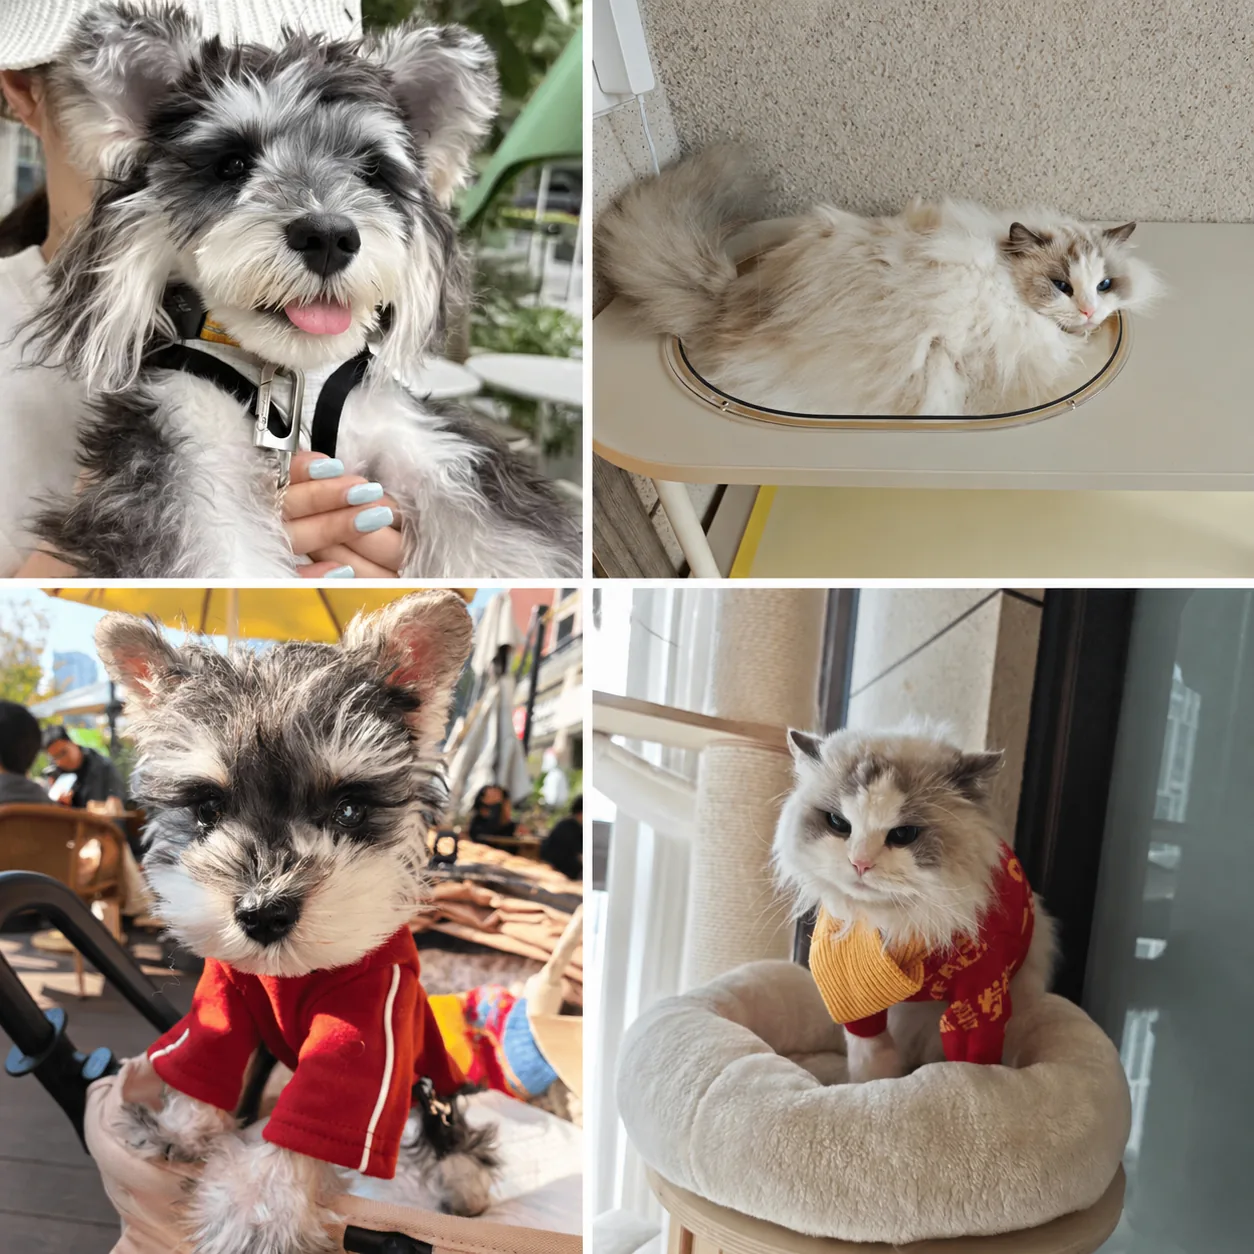
一只叫司令的雪纳瑞,一只叫钱钱的布偶猫;今年 9 月,又在宠博会上带回了小腊肠皮克嗦。它们负责巡逻、撒娇、偶尔制造一点小混乱,我负责见证它们长大。
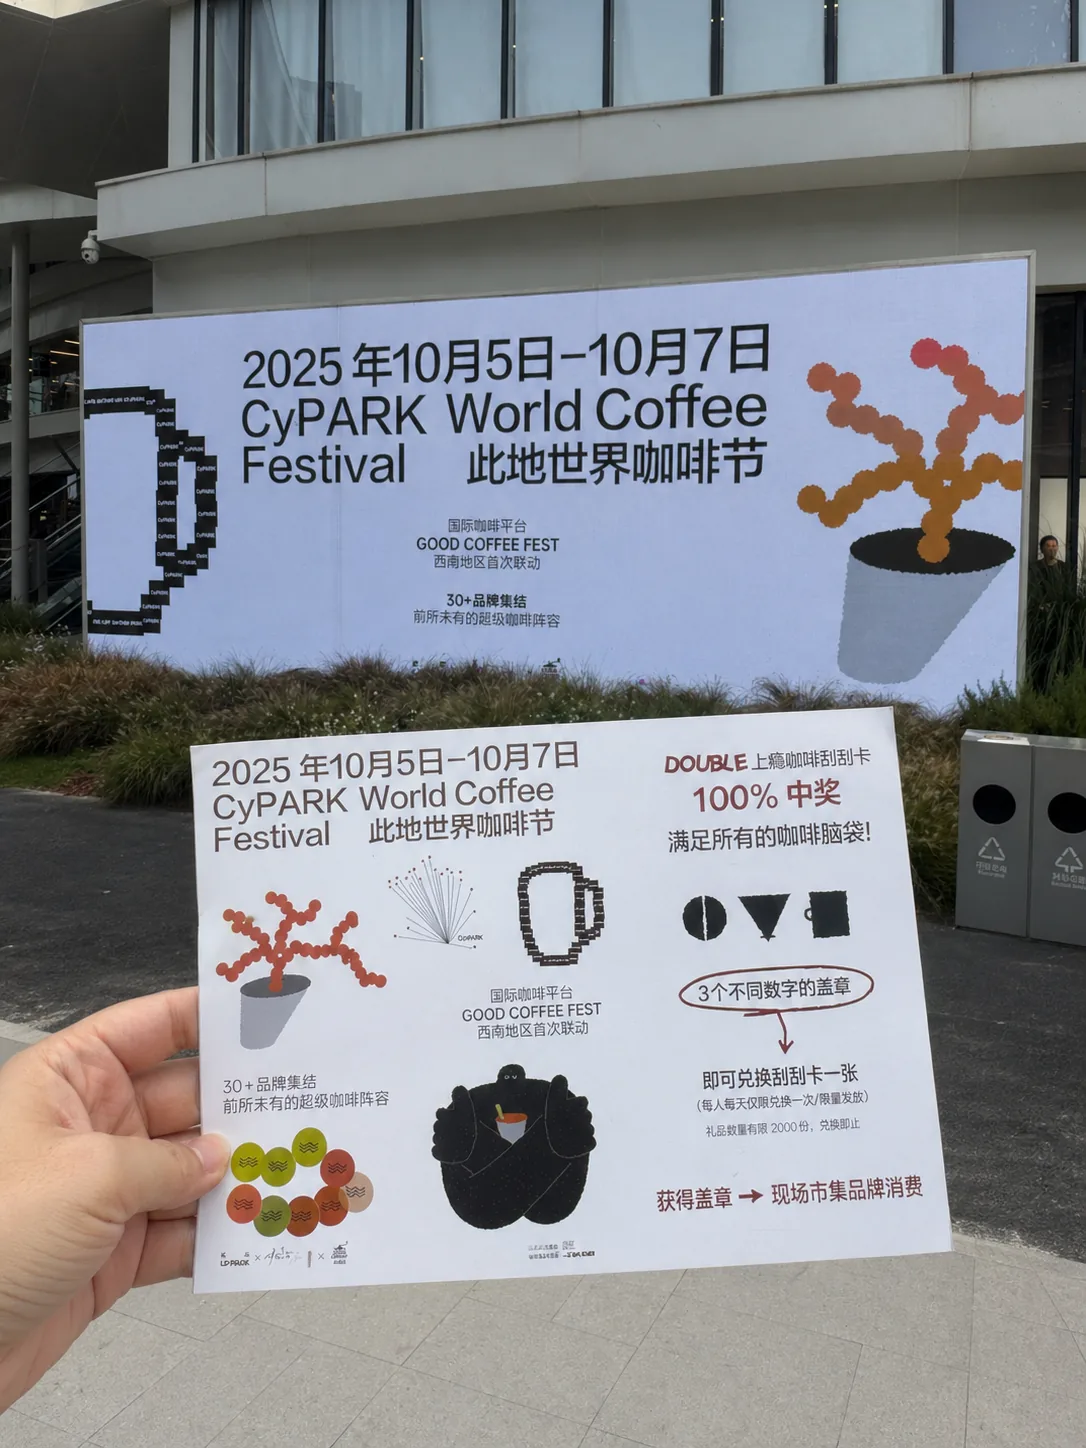
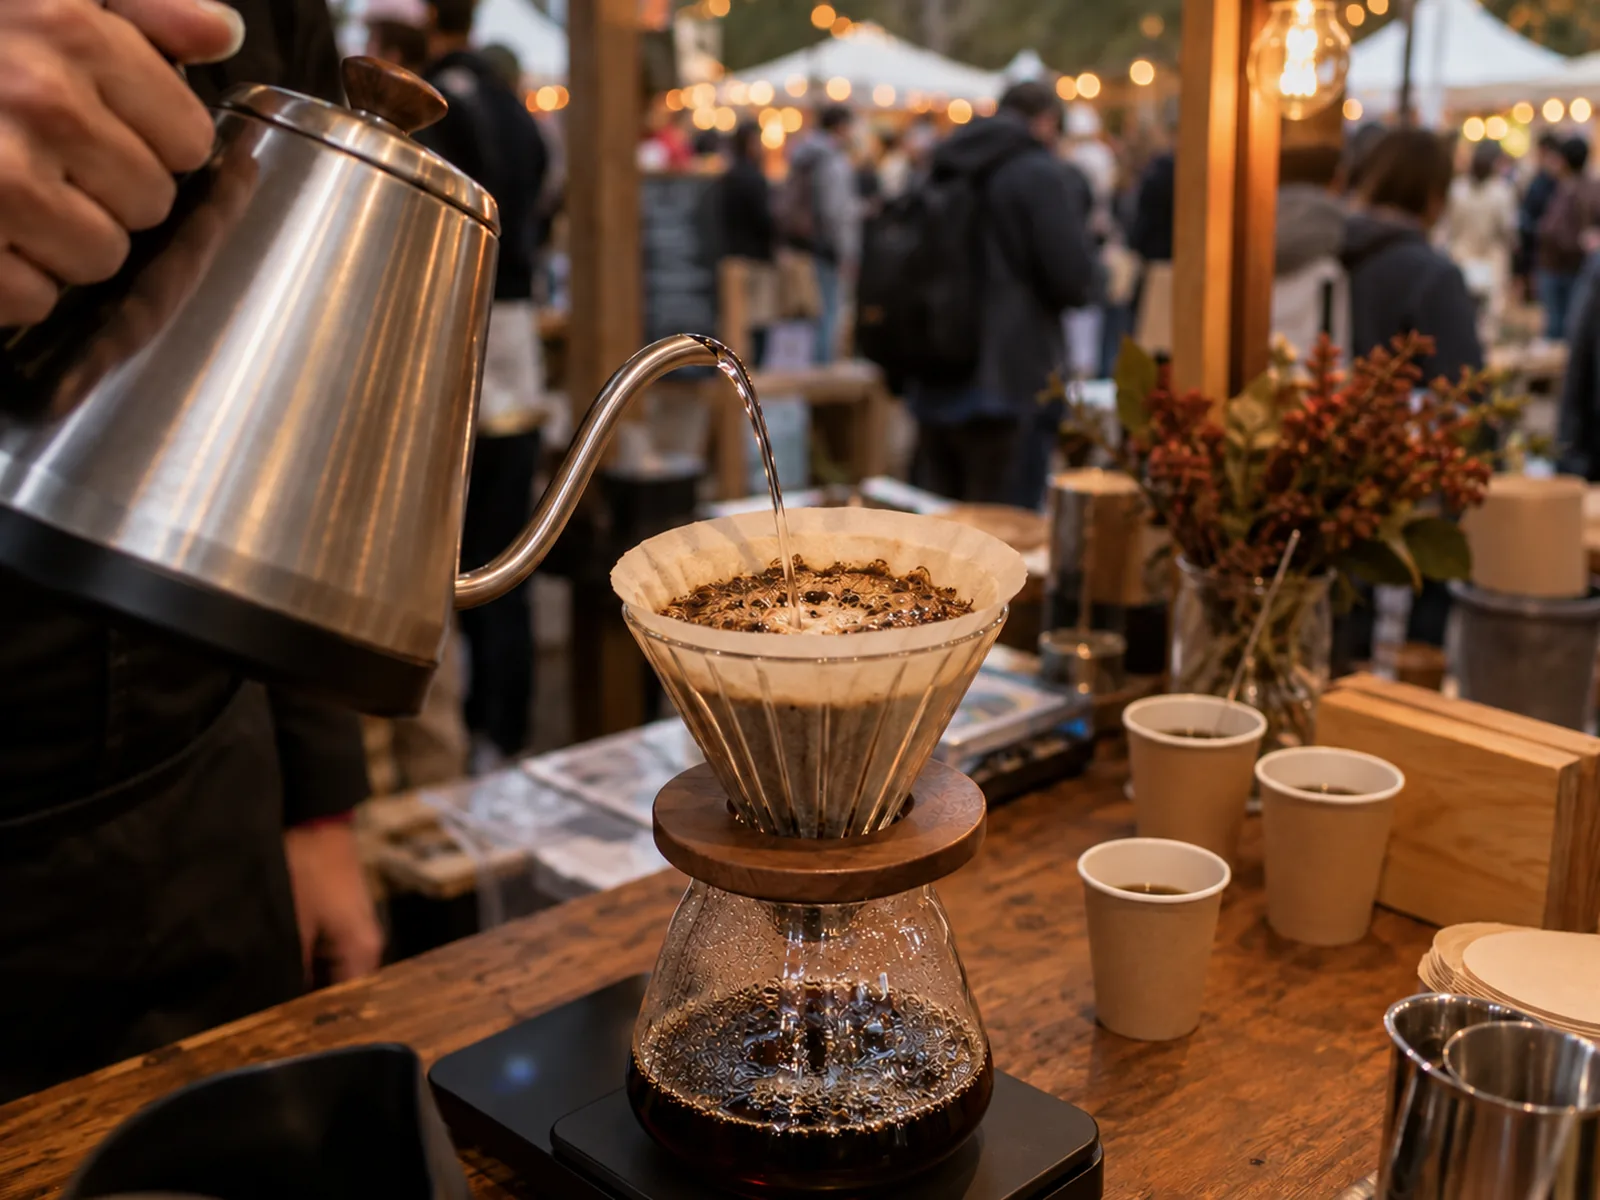
2025 年偶然路过 CyPARK 咖啡节,爱好就此开机;2026 年再去,这回上手试了咖啡大师的手法。半个品鉴大师,继续进修。
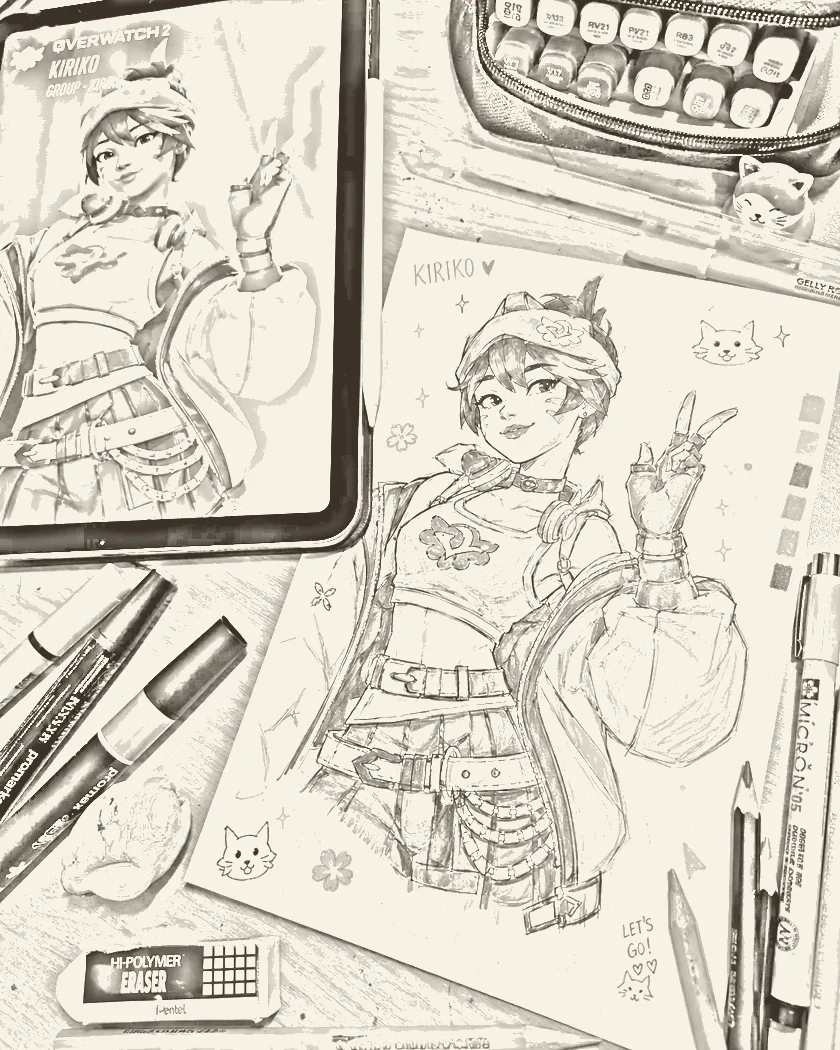
雾子皮肤返场,闲来无事就画雾子。我的理论非常朴素:画得越好,打得越 6。排位分数暂时还没被这套理论说服,但快乐已经先一步到账。
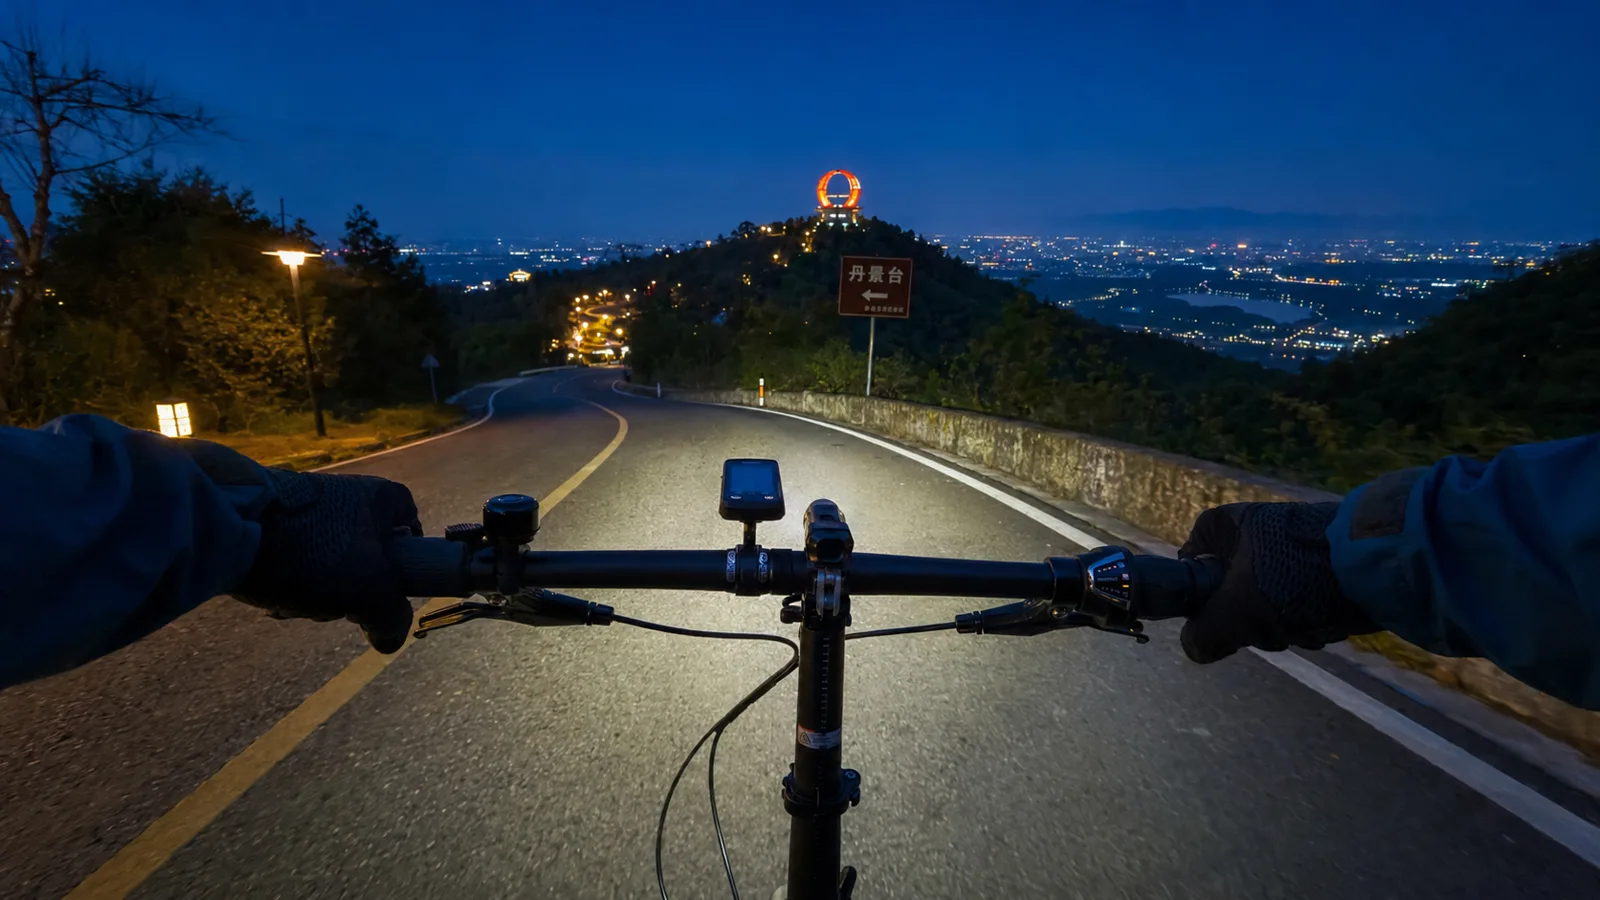
下班后沿着江边骑到路灯尽头再折返。不为锻炼,就为把白天开过的会一脚一脚踩碎。夜里的城市和白天不是同一座,连红绿灯都温柔了几分。
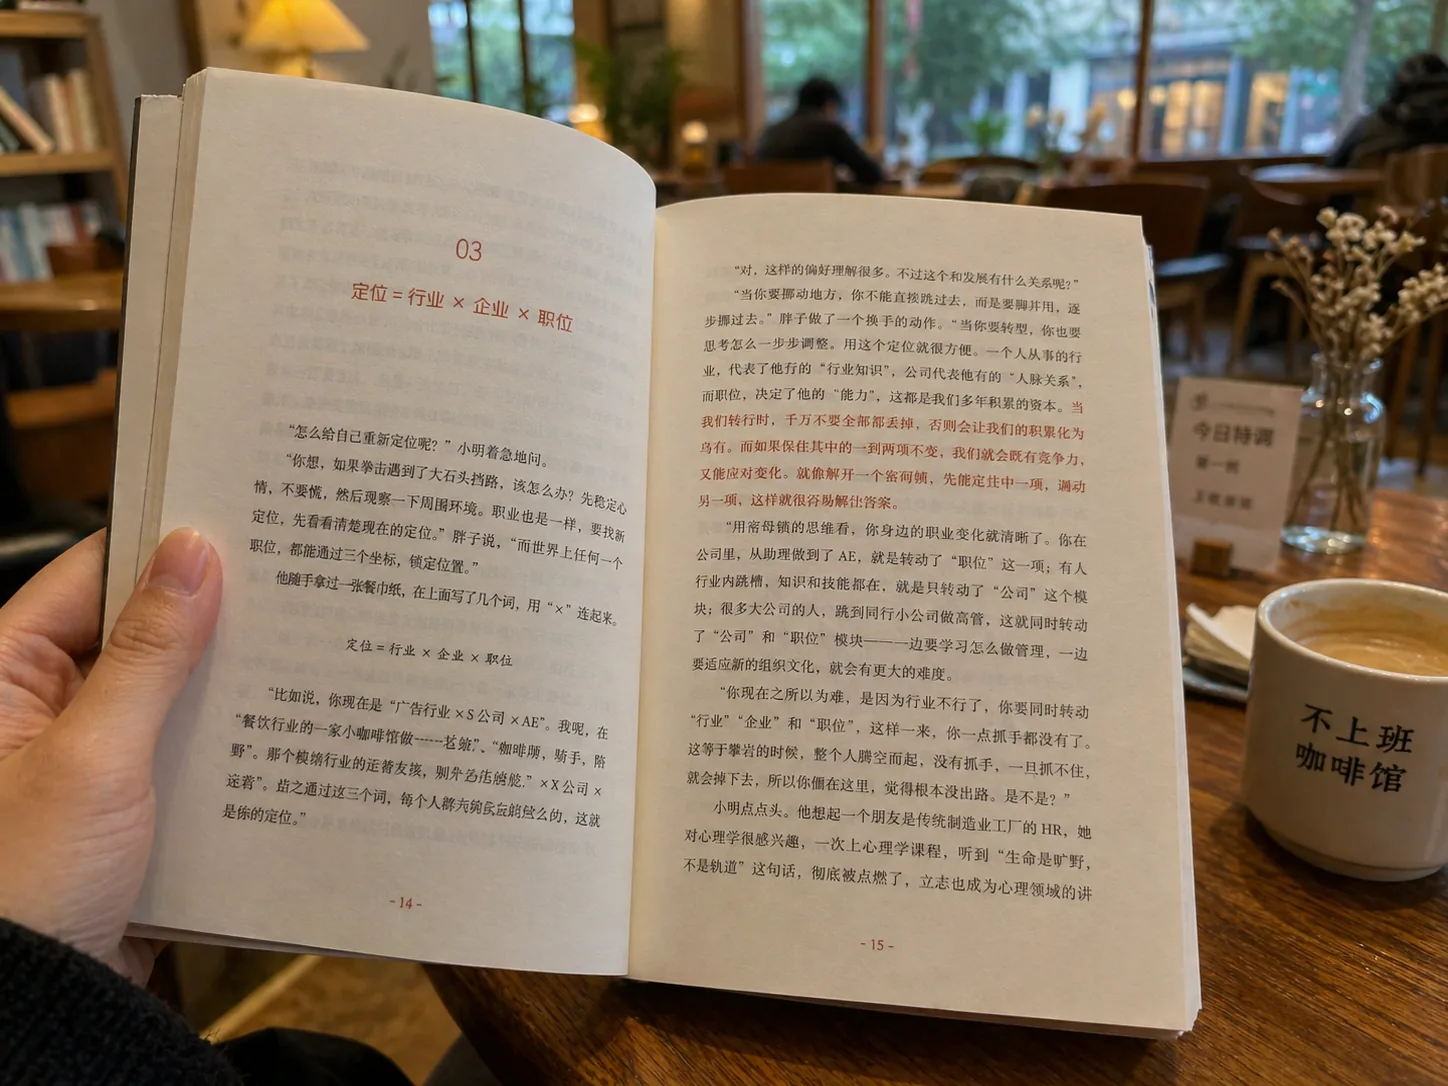
整理书架时发现,西西弗买回来的书还剩点没看。于是找个咖啡馆,把它读完。成年人的生活也需要一点解放,哪怕只是从一杯咖啡和一页书开始。
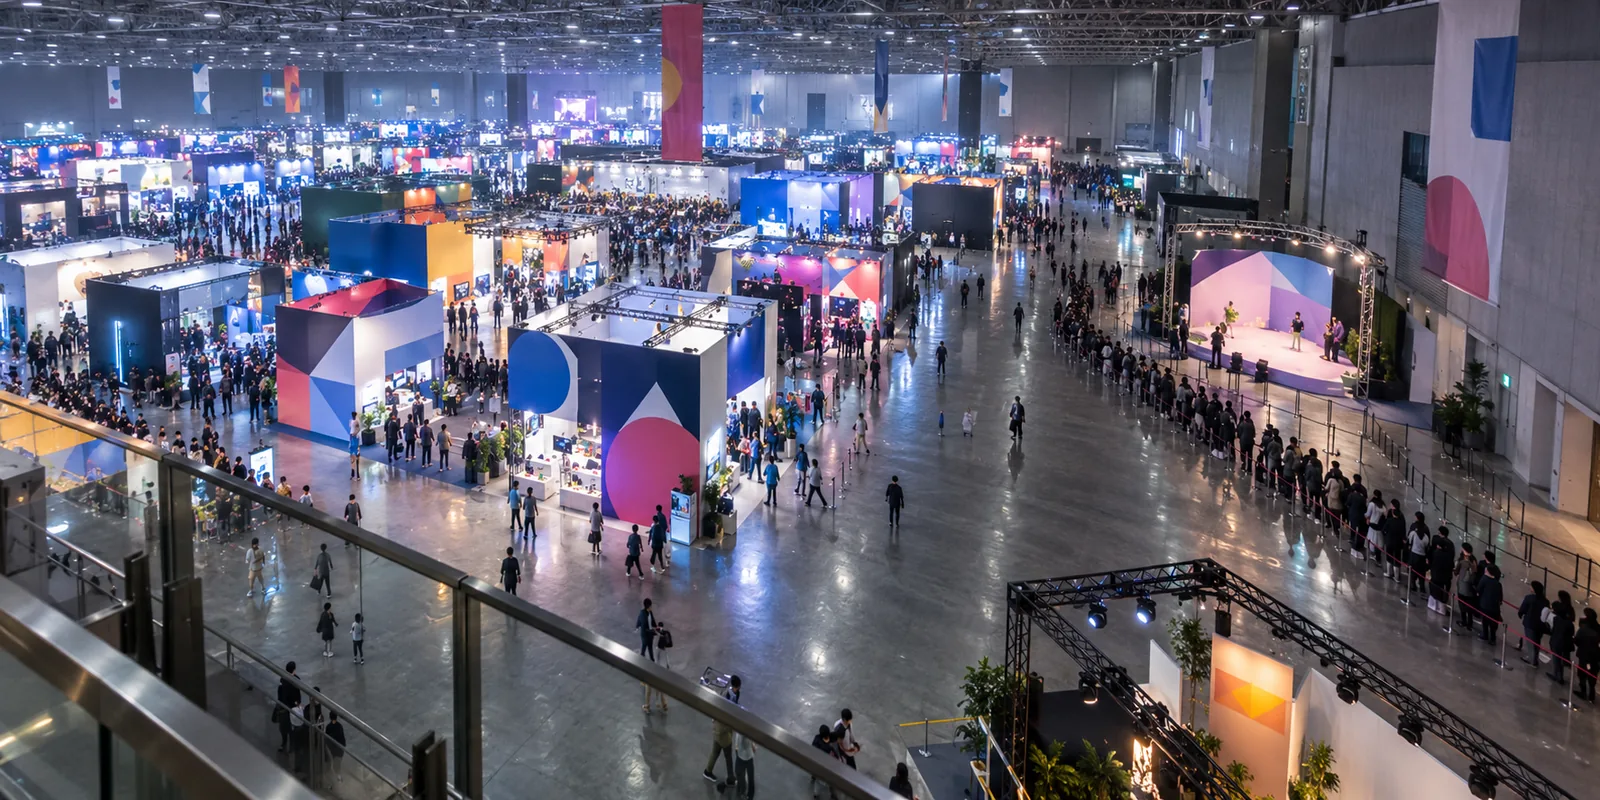
去了成都世界线动漫展,人生第一次逛漫展。现场氛围是真的热烈,但对打卡、集章这些玩法实在提不起兴趣。漫展留给真正热爱它的人。
一只叫司令的雪纳瑞,一只叫钱钱的布偶猫。它们负责在家里巡逻、撒娇、偶尔制造一点小混乱,我负责见证它们长大。人生能猫狗双全,已经算是偷偷攒到一张生活奖励券。
今年 9 月 13 日去了 TOPS 成都宠博会。那天正好是展会的最后一天,原本只是凑个热闹,最后却带回了一位新的家庭成员:一只棕褐色、长耳朵垂下来的小腊肠,取名皮克嗦。
司令和钱钱,从那天起多了个弟弟。皮克嗦会负责什么,还在观察中。家庭相册,也翻到了新的一页。
偶然路过 CyPARK 咖啡节,咖啡爱好就此开机。之后手冲、咖啡机样样俱全,从巴拿马的豆子喝到埃塞俄比亚,也算用杯子路过了世界上好几处咖啡产地。
9 月 25 日,咖啡节开幕第一天,又去了一趟 CyPARK。今年的此地世界咖啡节来了五十多个咖啡品牌,从亚洲一路排到欧洲、北美和大洋洲,现场一如既往地火热。
这次没满足于排队喝,跟着咖啡大师的手法自己试了试。从看别人做到自己动手,手上一点点的变化就足够让人开心。半个品鉴大师的头衔先续上,下一杯继续练。
10 月 4 日,去了成都世界线动漫展,在中国西部国际博览城,也是我人生第一次逛漫展。展馆里人从众,舞台、展台、coser 和排着长队的打卡点挤在一起,那种热烈的氛围,确实只有站在现场才感受得到。
但走了一圈,也确认了一件事:集章、打卡、排队合影这些玩法,我实在提不起兴趣。热闹看过了,好奇心也满足了。漫展留给真正热爱它的人,下一次,我大概不会再来了。
在做公共领域的 AI 落地,误报治理、端侧部署、Agent 派单都可以聊;也欢迎聊旅行和咖啡。